1. 关于文档
本章节简要概述了Reactor参考文档,你不必依次阅读该文档,每个章节都是独立的,尽管它们常链接其它的章节。
1.1. 最新版本 & 版权声明
Reactor参考文档也提供了HTML版本的,最新可用的副本在 https://projectreactor.io/docs/core/release/reference/index.html
无论是电子版还是纸质版的文档,只要你这些副本文档包含了版权声明,且不进行任何的收费,你都可以供自己使用或者分享给他人。
1.2. 贡献本文档
本参考文档是用 Asciidoc 写的,其源码位于 https://github.com/reactor/reactor-core/tree/master/docs/asciidoc 。
如果你有任何改进或建议,欢迎提交PR。
我们建议你check out源码到本地,便于你运行gradle asciidoctor 任务进行文档的构建以及检查渲染效果。有些部分章节依赖于其包含的文件,因此GitHub的渲染并不总是完整的。
| 为了便于文档编辑,大部分章节在末尾都有一个链接,可以打开一个直接编辑该章节源文件的GitHub界面。这些链接仅在HTML5版本的文档中提供,如下所示: Suggest Edit to 关于文档. |
1.3. 获取帮助
使用Reactor,你可以通过以下几种方式寻求帮助:
-
在 Gitter 上与社区取得联系。
-
在stackoverflow.com
project-reactor提问。 -
在Github issues上提交bug,我们密切关注这些仓库: reactor-core (包括核心功能)和 reactor-addons (涵盖响应式测试和适配器等问题)。
1.4. 如何开始
-
如果你想直接进入编程,前往 入门。
-
如果你刚接触响应式编程,你可能应该从 响应式编程介绍 开始。
-
如果你比较熟悉Reactor的概念,只是在寻找合适的操作,却想不到相关的操作符,请看附录 我需要哪个操作符?。
-
为了更深入地了解Reactor的核心功能,转至 Reactor核心特性 进行了解:
-
更多关于Reactor的响应式类型在
Flux,一个包含0-N个元素的异步序列 和Mono,一个包含0-1结果的异步序列 章节。 -
怎么使用 scheduler 进行线程上下文切换。
-
怎么处理错误在 错误处理 章节。
-
-
使用单元测试?在
reactor-test项目是可以做到的!请看 测试。 -
以编程方式创建序列 章节提供了更多高级的创建响应式源的方式。
-
高级特性和概念 章节涵盖了其它高级主题。
Suggest Edit to "关于文档"
2. 入门
本章节包含的信息有助于你使用Reactor,包含以下部分:
2.1. 介绍Reactor
Reactor是一个完全非阻塞的JVM响应式编程基础,有着高效的需求管理(背压的形式)。它直接整合Java8的函数式API,尤其是 CompletableFuture, Stream,还有 Duration 。提供了可组合的异步化序列API — Flux (对于 [N] 个元素) and Mono (对于 [0|1] 元素) — 并广泛实现
响应式Stream 规范。
Reactor还有支持非阻塞进程间通信的 reactor-netty 项目,适用于微服务架构,Reactor Netty为HTTP (包括Websockets),TCP和UDP提供了背压机制的网络引擎。完全支持响应式编解码。
2.2. 前提
Reactor Core运行在 Java 8 及之上。
对于 org.reactivestreams:reactive-streams:1.0.3 传递依赖。
|
Android的支持
|
2.3. 理解 BOM
Reactor 3使用BOM(依赖清单)模型(从 reactor-core 3.0.4 开始,以及 Aluminium 版本链)。
尽管这些组件之间可能存在版本分歧,但这份精选的组件列表,提供相关的版本,使其在一起能够运行良好。
BOM本身是版本化的,它使用了一个代号和限定符的版本链方案。下面的列表展示了一些样例:
Aluminium-RELEASE
Californium-BUILD-SNAPSHOT
Aluminium-SR1
Bismuth-RELEASE
Californium-SR32
版本代号表示为传统上的MAJOR.MINOR数字,它们(大部分)来于 元素周期表 ,按照字母顺序递增。
限定符(按照时间为顺序):
-
BUILD-SNAPSHOT:为开发和测试而构建的。 -
M1..N:里程碑或者开发人员预览的。 -
RELEASE:代号系列中第一个GA(可用的)版本。 -
SR1..N:代号系列中随后的GA版本 — 等同于修复数字。(SR表示“服务版本”)
2.4. 入门Reactor
正如 [前面提到的入门理解BOM],使用BOM和添加相关的依赖在你的工程中是最简单使用Reactor的方式。请注意,当你添加一个依赖时,你必须忽略版本,以便于从BOM中提取版本。
但是,如果你想强制的使用一个特定版本的组件,你可以像平时一样在添加依赖时指定其版本。你也可以完全放弃BOM,通过组件的版本指定其依赖。
2.4.1. Maven上的使用
Maven天然支持BOM的概念。首先你需要通过添加下面的片段到你的 pom.xml 来导入BOM。
<dependencyManagement> (1)
    <dependencies>
        <dependency>
            <groupId>io.projectreactor</groupId>
            <artifactId>reactor-bom</artifactId>
            <version>Bismuth-RELEASE</version>
            <type>pom</type>
            <scope>import</scope>
        </dependency>
    </dependencies>
</dependencyManagement>| 1 | 注意这 dependencyManagement 标签,这是除了常规 dependencies 的部分。 |
如果这顶层的选项(dependencyManagement)在你的pom中已经存在,仅需要添加内容。
接下来,除了没有 <version> 以外,像往常一样,添加你的依赖到相关的reactor工程中,如下所示。
<dependencies>
    <dependency>
        <groupId>io.projectreactor</groupId>
        <artifactId>reactor-core</artifactId> (1)
        (2)
    </dependency>
    <dependency>
        <groupId>io.projectreactor</groupId>
        <artifactId>reactor-test</artifactId> (3)
        <scope>test</scope>
    </dependency>
</dependencies>| 1 | 依赖核心库。 |
| 2 | 没有版本标签。 |
| 3 | reactor-test 用作对reactive streams进行单元测试。 |
2.4.2. Gradle上的使用
在Gradle5.0版本以前,没有对Maven BOM的核心支持,但是你可以使用Spring的 gradle依赖管理 插件。
首先,从Gradle插件入口应用该插件,如下所示:
plugins {
    id "io.spring.dependency-management" version "1.0.7.RELEASE" (1)
}| 1 | 在写本文档时,1.0.7.RELEASE是该插件最新的版本。请检查然后更新它。 |
然后使用它导入BOM,如下所示:
dependencyManagement {
     imports {
          mavenBom "io.projectreactor:reactor-bom:Bismuth-RELEASE"
     }
}
最后,不添加版本号将依赖添加到你的工程,如下所示:
dependencies {
     implementation 'io.projectreactor:reactor-core' (1)
}| 1 | 没有第三个 : 为版本分隔的部分,它取值于BOM。 |
从Gradle 5.0开始,你可以用原生的Gradle来支持BOM。
dependencies {
     implementation platform('io.projectreactor:reactor-bom:Bismuth-RELEASE')
     implementation 'io.projectreactor:reactor-core' (1)
}| 1 | 没有第三个 : 为版本分隔的部分,它取值于BOM。 |
2.4.3. 里程碑和快照
里程碑和开发者预览的版本是通过Spring里程碑仓库而不是中央仓库进行发布。请使用如下片段,要将其添加到你的构建配置文件中:
<repositories>
	<repository>
		<id>spring-milestones</id>
		<name>Spring Milestones Repository</name>
		<url>https://repo.spring.io/milestone</url>
	</repository>
</repositories>
对于Gradle,请使用下面的片段:
repositories {
  maven { url 'https://repo.spring.io/milestone' }
  mavenCentral()
}
同样的,快照版本也是在一个单独的专用仓库中可用,如下面的例子所示:
<repositories>
	<repository>
		<id>spring-snapshots</id>
		<name>Spring Snapshot Repository</name>
		<url>https://repo.spring.io/snapshot</url>
	</repository>
</repositories>repositories {
maven { url 'https://repo.spring.io/snapshot' }
mavenCentral()
}Suggest Edit to "入门"
3. 响应式编程介绍
Reactor是响应式编程范式的一种实现,概括如下:
响应式编程是一种涉及数据流和变化传播的异步编程范式。这意味着可以通过编程语言轻松地表示静态(如数组)或动态(如事件发射器)数据流。
作为响应式编程方向上的第一步,Microsoft在.NET生态中创建了响应式(Rx)扩展库。然后RxJava实现了JVM上的响应式编程。随着时间的推移,通过Reactive Streams的努力,一套基于JVM为响应式库定义接口与交互规则的标准规范`Reactive Streams` 出现了。其接口已经集成到了Java9中的 Flow 类下。
响应式编程经常作为观察者设计模式的一种扩展在面向对象编程语言中体现。你还可以将响应式流模式和熟悉的迭代器设计模式进行比较,它们的核心库都基于 Iterable-Iterator 组合。一个主要的区别是,迭代器基于拉的,而响应式流是基于推的。
迭代器是一种命令式编程模式,即使获取值完全取决于 Iterable。事实上,这取决于开发者在序列中选择何时调用 next()。在响应式流中,上面的组合等价于 Publisher-Subscriber 。但当有新的可用的数据到来时,Publisher 会对订阅者进行通知,这种推动是响应式的关键。当然,使用推送值的操作应表现为声明式的而不是命令式的:开发者应专注于表达逻辑计算而不是描述确切的流控制。
除了推送数据外,还以明确的覆盖了错误处理和完成方面。Publisher 可以推送新的数据到其 Subscriber(通过调用 onNext ),也可以发送错误(通过调用 onError)或者完成(通过调用 onComplete)信号。错误和完成信号都会终止序列。可以总结如下:
onNext x 0..N [onError | onComplete]这种方式非常灵活,适用于零个值,一个值或者N个值(包括无限序列,例如持续的时钟滴答声)。
但是首先需要思考的是,我们为什么需要这样的异步响应式库呢?
3.1. 阻塞更浪费资源
现代应用程序有着巨大的并发用户,即使当代的硬件性能已经提升了不少,但是软件的性能依然是一个关键因素。
通常有两种方式来提升应用的性能:
-
使用更多的线程和硬件资源达到 并行化
-
在当前使用的资源上 寻求更高效的处理
通常,Java开发者使用同步方式编程,这种做法在遇到性能瓶颈之前是可行的。当然此时可能会引入更多的线程来运行相同的同步代码。但是像这种资源利用率的扩展,很快会引入竞争和并发的问题。
更糟糕的是,阻塞浪费资源。如果你仔细观察,一旦程序涉及一些延时操作(特别是I/O,例如数据库请求或者网络调用),由于线程(可能有很多线程)等待数据而处于空闲,导致资源的浪费。
因此,并行化并不是银弹。虽然为了充分利用硬件资源是有必要的,但是也带来了复杂性和容易造成资源浪费。
3.2. 异步能拯救?
先前提到的第二种方式,寻求更高的效率,可以解决资源浪费问题。通过编写异步非阻塞的代码,你可以将执行切换到使用了相同底层资源的另一个活动任务,然后在异步处理完成后返回到当前任务。
但是你如何在JVM上编写异步代码?Java提供了两种异步编程模型:
-
Callbacks:异步方法没有一个返回值,但是它额外的传递了一个
callback参数(lambda或者匿名类),在当结果可返回时调用。熟知的例子就是Swing的EventListener体系。 -
Futures:异步方法 立即 返回一个
Future<T>。异步处理计算得到这个T值,Future对象对获取该值进行了包装,这个对象可以一直轮询直到返回该值。例如,ExecutorService使用Future对象执行Callable<T>任务。
这些技术够好?并不适用于每个用例,两种方式都有局限性。
回调难以组合在一起,很容易导致代码难以阅读和维护(著名的地狱回调)。
举个例子:在界面上展示一个用户的最优先的五个喜好,如果都没有,则在界面上进行建议。通过调用三个服务(第一个提供喜好ID,第二个获取喜好详情,第三个提供详情建议),如下所示:
userService.getFavorites(userId, new Callback<List<String>>() { (1)
  public void onSuccess(List<String> list) { (2)
    if (list.isEmpty()) { (3)
      suggestionService.getSuggestions(new Callback<List<Favorite>>() {
        public void onSuccess(List<Favorite> list) { (4)
          UiUtils.submitOnUiThread(() -> { (5)
            list.stream()
                .limit(5)
                .forEach(uiList::show); (6)
            });
        }

        public void onError(Throwable error) { (7)
          UiUtils.errorPopup(error);
        }
      });
    } else {
      list.stream() (8)
          .limit(5)
          .forEach(favId -> favoriteService.getDetails(favId, (9)
            new Callback<Favorite>() {
              public void onSuccess(Favorite details) {
                UiUtils.submitOnUiThread(() -> uiList.show(details));
              }

              public void onError(Throwable error) {
                UiUtils.errorPopup(error);
              }
            }
          ));
    }
  }

  public void onError(Throwable error) {
    UiUtils.errorPopup(error);
  }
});| 1 | 我们提供了基于回调的服务:一个`Callback` 接口包含当异步处理成功和失败时的两个方法。 |
| 2 | 第一个服务使用喜好列表ID执行回调。 |
| 3 | 如果列表为空,则必须转到 suggestionService。 |
| 4 | suggestionService 将 List<Favorite> 给到第二个回调。 |
| 5 | 由于我们处理的是UI,我们需要确保我们的消费代码跑在UI线程。 |
| 6 | 我们使用Java8 Stream 来限制建议的数量为5个,并且将它们展示在UI的图形列表中。 |
| 7 | 在每个级别,我们都以相同的方式处理错误:将其显示在弹出窗口中。 |
| 8 | 返回到喜好ID级别。如果服务返回了完整的列表,我们需要转到 favoriteService 来获取详细的 Favorite 对象。因为我们只需要五个,所以我们首先将ID列表的流限制为5个。 |
| 9 | 再一次回调。这一次我们得到一个完整的 Favorite 对象,我们在UI线程内将其推送到UI。 |
存在大量包含重复且难以追踪的代码。在Reactor实现相同的功能:
userService.getFavorites(userId) (1)
           .flatMap(favoriteService::getDetails) (2)
           .switchIfEmpty(suggestionService.getSuggestions()) (3)
           .take(5) (4)
           .publishOn(UiUtils.uiThreadScheduler()) (5)
.subscribe(uiList::show, UiUtils::errorPopup); (6)| 1 | 我们从一个喜好ID的流开始。 |
| 2 | 我们 异步地将它们转换 为详细的 Favorite 对象(flatMap)。现在我们有了一个 Favorite 的流。 |
| 3 | 如果 Favorite 流为空,我们降级到 suggestionService。 |
| 4 | 我们最多只关注结果流中的五个元素。 |
| 5 | 最后我们处理UI线程中的每个元素。 |
| 6 | 我们通过描述最终如何处理数据的形式来触发流(在UI列表中显示)以及出现错误时的操作(显示弹出窗口)。 |
如果想要确保在800ms内检索到喜好ID,当耗时较长时,从缓存中获取?在基于回调的代码中,这是一个复杂的任务。在Reactor中,在链中添加一个 timeout 操作符就变得非常简单,如下所示:
userService.getFavorites(userId)
           .timeout(Duration.ofMillis(800)) (1)
           .onErrorResume(cacheService.cachedFavoritesFor(userId)) (2)
           .flatMap(favoriteService::getDetails) (3)
           .switchIfEmpty(suggestionService.getSuggestions())
           .take(5)
           .publishOn(UiUtils.uiThreadScheduler())
.subscribe(uiList::show, UiUtils::errorPopup);| 1 | 如果以上部分在800ms内没有发射出元素,则传播一个错误。 |
| 2 | 如果发生错误,降级到 cacheService。 |
| 3 | 链的其余部分与前面的示例类似。 |
Future 对象比回调稍微好一点,但依然难以进行组合,尽管Java8中 CompletableFuture 对其做了改进。编排多个 Future 对象在一起虽然是可以行的,但并不容易。另外,Future 有其它的问题:
-
调用
get()方法很容易导致Future对象出现另一个阻塞的情况。 -
不支持惰性计算。
-
缺乏对多值和高级错误处理的支持。
考虑另外一个示例:获取到一个ID列表,我们需要获取其名称或统计信息并将其组合,且所有的操作都是异步的。下面的例子使用 CompletableFuture 类型列表执行此操作:
CompletableFuture 组合示例CompletableFuture<List<String>> ids = ifhIds(); (1)
CompletableFuture<List<String>> result = ids.thenComposeAsync(l -> { (2)
Stream<CompletableFuture<String>> zip =
l.stream().map(i -> { (3)
CompletableFuture<String> nameTask = ifhName(i); (4)
CompletableFuture<Integer> statTask = ifhStat(i); (5)
return nameTask.thenCombineAsync(statTask, (name, stat) -> "Name " + name + " has stats " + stat); (6)
});
List<CompletableFuture<String>> combinationList = zip.collect(Collectors.toList()); (7)
CompletableFuture<String>[] combinationArray = combinationList.toArray(new CompletableFuture[combinationList.size()]);
CompletableFuture<Void> allDone = CompletableFuture.allOf(combinationArray); (8)
return allDone.thenApply(v -> combinationList.stream()
.map(CompletableFuture::join) (9)
.collect(Collectors.toList()));
});
List<String> results = result.join(); (10)
assertThat(results).contains(
"Name NameJoe has stats 103",
"Name NameBart has stats 104",
"Name NameHenry has stats 105",
"Name NameNicole has stats 106",
"Name NameABSLAJNFOAJNFOANFANSF has stats 121");| 1 | 从一个给定需要处理的 id 列表开始。 |
| 2 | 一旦得到列表,我们需要进一步的异步处理。 |
| 3 | 遍历列表中的每个元素。 |
| 4 | 异步获取关联的名称。 |
| 5 | 异步获取关联的任务。 |
| 6 | 合并结果。 |
| 7 | 现在,我们有了表示所有组合任务的future列表。为了执行这些任务,我们需要转换列表为数组。 |
| 8 | 将数组传递给 CompletableFuture.allOf,输出到一个 Future 对象,然后当所有的任务都完成后完成。 |
| 9 | 棘手的是,allOf 返回 CompletableFuture<Void> ,我们重新遍历future列表,使用 join() 收集其结果(这里不会阻塞,因为 allOf 已经确保这些futures已经完成)。 |
| 10 | 一旦触发了整个异步链,我们就可以等待其执行结果返回,且断言返回的结果。 |
由于Reactor提供了更多开箱即用的组合运算符,这个过程可以被简化如下:
Flux<String> ids = ifhrIds(); (1)

Flux<String> combinations =
		ids.flatMap(id -> { (2)
			Mono<String> nameTask = ifhrName(id); (3)
			Mono<Integer> statTask = ifhrStat(id); (4)

			return nameTask.zipWith(statTask, (5)
					(name, stat) -> "Name " + name + " has stats " + stat);
		});

Mono<List<String>> result = combinations.collectList(); (6)

List<String> results = result.block(); (7)
assertThat(results).containsExactly( (8)
		"Name NameJoe has stats 103",
		"Name NameBart has stats 104",
		"Name NameHenry has stats 105",
		"Name NameNicole has stats 106",
		"Name NameABSLAJNFOAJNFOANFANSF has stats 121"
);| 1 | 这一次,我们从已提供的一个异步序列 ids(Flux<String>)开始。 |
| 2 | 对于序列中的每个元素,我们异步处理(在调用的 flatMap 函数内部)两次。 |
| 3 | 获取关联的名称。 |
| 4 | 获取关联的统计信息。 |
| 5 | 异步合并两个结果值。 |
| 6 | 在值可用时聚合到 List 中。 |
| 7 | 在生产中,我们会进一步通过 Flux 异步的组合或者订阅。一般情况下,我们会返回 result Mono。由于我们现在用作测试,我们阻塞等待结果处理完成,然后直接返回聚合的值列表。 |
| 8 | 断言结果。 |
使用回调和 Future 对象的缺点是相似的,且是 Publisher-Subscriber 的响应式编程所要解决的问题。
3.3. 从命令式到响应式编程
诸如Reactor之类的响应式库,旨在解决JVM上这些 " 经典 "的异步方法的缺点,同时还关注一些其它的方面:
-
组合性 和 易读性
-
数据作为 流 操作,且有着丰富的 操作符
-
在 订阅 之前什么都不会发生
-
背压 或 消费者向生产者发送信号表示发布速率太快
-
与 并发无关 的高阶抽象
3.3.1. 组合性和易读性
"可组合性"是指能够编排多个异步任务,我们使用先前任务的结果将输入提供给后续任务。另外,我们可以以fork-join的形式运行多个任务。此外,我们能复用异步任务作为离散组件到更高层次的系统中。
编排任务的能力是与代码的可读性和可维护性紧密耦合。随着异步处理的层数和复杂性的增加,编写和阅读代码变得越来越困难。正如我们看到的一样,整个回调模型是非常简单的,但是其主要的缺点之一是,对于复杂的处理,你需要从一个回调中执行一个回调,其本身嵌套在另一个回调中,依此类推。这种混乱被称为"地狱回调"。正如你所料到的(或从经验得知),如此的代码是相当难以回溯和推理的。
Reactor提供了丰富的组合选项,其中在代码中反映了抽象过程,并且所有内容通常保持在同一级别(减少嵌套)。
3.3.2. 类比流水线
你可以将响应式应用数据处理当作在组装流水线上流动。Reactor既是流水线又是工作站。原料来源于(原始的 Publisher)并最终作为一个产品,准备推送到消费者(Subscriber)。
原料可以通过各种转换和其它的中间步骤,或者将中间零件聚合在一起成为更大的流水线的一部分。如果在某一点出现故障或者堵塞(也许产品装箱所需时间过长),当前被影响到的工作站可以向上游发出信号来限制原料的流动。
3.3.3. 操作符
在Reactor中,操作符是我们流水线类比中的工作站。每个操作符添加行为到 Publisher 中,并将上一步的 Publisher 包装到新的实例中。因此,整个链被链接在一起,数据源于第一个 Publisher 沿着链向下移动,并通过每个链接进行转换。最终,Subscriber 完成处理。记住,正如我们很快会看到的,在 Subscriber 订阅 Publisher 之前,什么都不会发生。
| 理解操作符创建新的实例可以帮助你避免一个常见的错误,该错误会导致你认为你在链中使用的运算符未被应用。请参见FAQ中 item。 |
尽管在响应式流规范中根本没有指定操作符,Reactor作为优秀响应式库中之一的添加了这些操作,提供了丰富的操作符。且涉及了很多方面,从简单的转换和过滤到复杂的编排和错误处理。
3.3.4. subscribe() 之前什么都不会发生
在Reactor中,当你写一个 Publisher 链时,默认情况下不会开始注入数据。相反,你可以创建异步处理(有助于重用和组合)的抽象描述。
通过 订阅,可以将 Publisher 与 Subscriber 进行绑定,从而触发整个链中的流数据。这是在内部实现的,通过单个 request 信号从 Subscriber 传播到上游,一直传回到 Publisher。
3.3.5. 背压
向上游传播信号也用作实现 背压,我们在组装流水线类比中将其描述为,当工作站的处理速度比上游工作站慢时,沿生产线向上发送反馈信号。
响应式流规范所定义的实际机制与类比非常接近:一个订阅者可以以 无界 模式工作,并让源以其最快的速率推送所有的数据,也可以使用 request 机制向源发送信号,表明已准备好最多处理 n 个元素。
中间操作符也可以在中途改变请求。设想一个以十为一组将元素进行分组的 buffer 操作符。如果订阅者请求一个buffer,源可以生成十个元素。一些操作符还实现了 提前获取 的策略,能够避免 request(1) 往返,如果在请求之前生产元素的成本不太高,那么这种策略是有益的。
这会将推模式转换为 推拉混合,当元素随时可用时,下游可以从上游获取n个元素。但是如果这些元素还没准备好,每当它们被生产时,就会被上游推送到下游。
3.3.6. 热 vs 冷
Rx系列的响应库区分了两大类响应式序列:热 和 冷,这种区别主要与响应式流如何对订阅者作出反应相关:
-
一个 冷 的序列会对每个
Subscriber都重新开始,包括数据源。例如,如果源包装了一个HTTP调用,则会为每个订阅发起一个新的HTTP请求。 -
一个 热 的序列对每个
Subscriber并非是从头开始。更确切地说,晚到的订阅者会在订阅后接收到发送的信号。但是注意,有些热的响应式流可以缓存或者重置全部或部分下发历史。从一般的角度来看,一个热的序列即使没有订阅者处于监听(对于"`订阅之前什么都不会发生`"规则是个例外),也能下发。
关于Reactor上下文中热与冷的更多信息,请看 reactor专门章节。
Suggest Edit to "响应式编程介绍"
4. Reactor核心特性
Reactor项目的主要组件为 reactor-core,一个专注于响应式流规范并基于Java8的响应式库。
Reactor引入了可组合的响应式类型,这些类型既实现了 Publisher 又提供了丰富的操作符:Flux 和 Mono。一个 Flux 对象表示含有0..N个元素的响应式序列。而一个 Mono 对象表示单个值或为空(0..1)的结果。
这种区别在类型中包含了一些语义信息,表明异步处理的初略基数。例如,一个HTTP请求仅一个响应,因此执行 count 操作没有太大的意义。因此对于一次HTTP调用的结果表示为 Mono<HttpResponse> 相较于 Flux<HttpResponse> 更有意义,因为它仅提供零项或者一项与上下文相关的的操作符。
操作符也能转换到相关类型,来改变要处理的最大基数。例如,count 操作符存在于 Flux,但它返回的是 Mono<Long>。
4.1. Flux,一个包含0-N个元素的异步序列
下图显示了 Flux 如何转换元素:
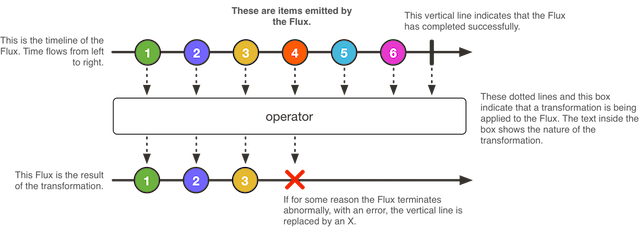
Flux<T> 是一个标准的 Publisher<T>,表示为发出0到N个元素的异步序列,可由完成或者错误信号进行选择性终止。在响应式流规范中,这三种类型信号转换为调用下游订阅者的 onNext ,onComplete,和 onError 方法。
在如此之大可能信号的范围的情况下,Flux 是通用的响应式类型。请注意所有的事件,甚至是终止事件都是可选的:没有 onNext 事件但是有 onComplete 事件表示为一个 空 的有限序列,但去掉 onComplete ,会有一个 无限 的空序列(除了关于取消的测试外,并没有什么用)。同样,无限序列并不一定总为空的。例如,Flux.interval(Duration) 产生一个无穷的且周期性的发出的 Flux<Long> 。
4.2. Mono,一个包含0-1结果的异步序列
下图显示了 Mono 如何转换元素:
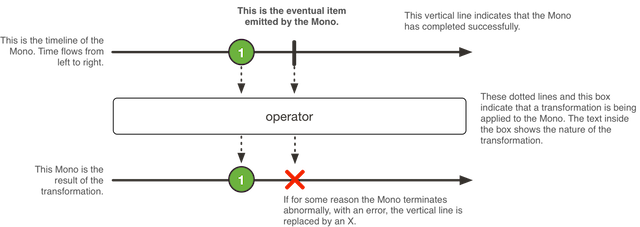
Mono<T> 是一个特定的 Publisher<T>,最多可以发出一个元素,可以被 onComplete 或 onError 信号选择性终止。
它仅提供可用于 Flux 的子集操作符,且一些操作符(特别是那些将 Mono 和另一个 Publisher 结合起来的操作符)能够切换到 Flux。例如,Mono#concatWith(Publisher) 返回一个 Flux,而 Mono#then(Mono) 返回另一个 Mono。
注意,你可以使用 Mono 来表示具有完成(类似于 Runnable)概念的无值异步处理。使用 Mono<Void> 来进行创建。
4.3. 简单创建和订阅Flux或Mono
使用各自类中众多的工厂方法之一是上手 Flux 和 Mono 的最简单的方式。
例如,要创建一个 String 序列,可以枚举它们或者将它们放入到一个集合中,并从中创建Flux,如下所示:
Flux<String> seq1 = Flux.just("foo", "bar", "foobar");

List<String> iterable = Arrays.asList("foo", "bar", "foobar");
Flux<String> seq2 = Flux.fromIterable(iterable);
其它工厂方法示例包括如下:
Mono<String> noData = Mono.empty(); (1)

Mono<String> data = Mono.just("foo");

Flux<Integer> numbersFromFiveToSeven = Flux.range(5, 3); (2)| 1 | 注意,即使整个工厂方法没有任何值,也需要标注泛型类型。 |
| 2 | 第一个参数是范围的开始,第二个参数是产生元素的个数。 |
在订阅时,Flux 和 Mono 使用Java8的lambda语法。你可以选择各种各样的 .subscribe() 形式,将lambda使用于不同的回调组合,如下面的方法签名所示:
Flux 的订阅形式subscribe(); (1)
subscribe(Consumer<? super T> consumer); (2)
subscribe(Consumer<? super T> consumer,
Consumer<? super Throwable> errorConsumer); (3)
subscribe(Consumer<? super T> consumer,
Consumer<? super Throwable> errorConsumer,
Runnable completeConsumer); (4)
subscribe(Consumer<? super T> consumer,
Consumer<? super Throwable> errorConsumer,
Runnable completeConsumer,
Consumer<? super Subscription> subscriptionConsumer); (5)| 1 | 订阅并触发序列。 |
| 2 | 对每个产生的值做一些操作。 |
| 3 | 处理值时也会对错误作出反应。 |
| 4 | 处理值和错误,且在序列成功完成时运行一些代码。 |
| 5 | 处理值和错误以及成功完成,但也要处理 subscribe 调用产生的 Subscription。 |
这些不同的形式会返回订阅的引用,当不需要更多的数据时,可以通过该引用来取消订阅。取消后,源应停止生产数据并清除它所创建的任何资源。在Reactor中,使用通用 Disposable 接口来表示取消和清理行为。
|
4.3.1. subscribe 方法示例
本节包含了 subscribe 方法的五个签名的最简单示例。以下代码显示了一个没有参数的基本方法的例子:
Flux<Integer> ints = Flux.range(1, 3); (1)
ints.subscribe(); (2)| 1 | 设置一个 Flux,在订阅者连接时生成三个值。 |
| 2 | 用最简单的方式订阅。 |
前面的代码不会产生任何可见的输出,但它确实起作用。Flux 产生三个值。如果我们提供一个lambda,则可以让这些值可见。subscribe 方法的下一个示例显示了一种使值显示的方法:
Flux<Integer> ints = Flux.range(1, 3); (1)
ints.subscribe(i -> System.out.println(i)); (2)| 1 | 设置一个 Flux,在订阅者连接时生成三个值。 |
| 2 | 用能打印值的订阅者进行订阅。 |
前面的代码产生以下输出:
1
2
3
为了演示下一个方法签名,我们故意引入一个错误,如下例所示:
Flux<Integer> ints = Flux.range(1, 4) (1)
      .map(i -> { (2)
        if (i <= 3) return i; (3)
        throw new RuntimeException("Got to 4"); (4)
      });
ints.subscribe(i -> System.out.println(i), (5)
error -> System.err.println("Error: " + error));| 1 | 设置一个 Flux,在订阅者连接时生成四个值。 |
| 2 | 我们需要一个map,这样我们就可以对一些值进行不同的处理。 |
| 3 | 对于大多数值,返回该值。 |
| 4 | 对于一个值,强制发生错误。 |
| 5 | 用包括错误处理的订阅者进行订阅。 |
我们现在有两个lambda表达式:一个是我们期望的内容,一个是错误。前面的代码产生以下输出:
1
2
3
Error: java.lang.RuntimeException: Got to 4
subscribe 方法的下一个签名包括错误处理和完成事件处理,如下示例所示:
Flux<Integer> ints = Flux.range(1, 4); (1)
ints.subscribe(i -> System.out.println(i),
    error -> System.err.println("Error " + error),
() -> System.out.println("Done")); (2)| 1 | 设置一个 Flux,在订阅者连接时生成四个值。 |
| 2 | 用包含完成事件处理的订阅者进行订阅。 |
错误信号和完成信号都是终止事件,并且彼此互斥(你永远不会同时得到这两个信号)。为了完成消费,我们必须注意不要触发错误。
完成回调没有输入,用一对空括号表示:它与 Runnable 接口中的 run 方法相匹配。上面的代码产生以下输出:
1
2
3
4
Done
subscribe 方法的最后一个签名包括一个 Consumer<Subscription>。
这种形式要求你对 Subscription(对其执行 request(long) 或 cancel())做一些事情。否则 Flux 会挂起。
|
以下示例显示了 subscribe 方法的最后一个签名:
Flux<Integer> ints = Flux.range(1, 4);
ints.subscribe(i -> System.out.println(i),
    error -> System.err.println("Error " + error),
    () -> System.out.println("Done"),
sub -> sub.request(10)); (1)| 1 | 当我们订阅时,我们会收到一个 Subscription。表示我们最多希望从源(实际上会发出4个元素并完成)中接收到 10 个元素。 |
4.3.2. 用 Disposable 取消 subscribe()
所有这些基于lambda的 subscribe() 形式都有一个 Disposable 返回类型。在这种情况下,Disposable 接口表示订阅都可以通过调用其 dispose() 方法来 取消 订阅。
对于 Flux 或 Mono 来说,取消是源应该停止产生元素的信号。然而,并不能保证立即执行:某些源可能产生元素的速度太快,以至于它们甚至可以在收到取消指令之前就能完成。
Disposables 类中提供了一些关于 Disposable 的工具集。其中,Disposables.swap() 创建了一个 Disposable 包装器,让你可以原子地取消和替换一个具体的 Disposable。这在UI场景中会非常有用,例如,当用户单击按钮时,你想取消请求并将其替换为新的请求。处理包装本身会关闭它。这样做会处理掉当前的具体值和所有未来尝试的替换。
另一个有趣的工具方法是 Disposables.composite(…)。这个组合可以让你收集多个 Disposable — 例如,与一个服务调用相关联的多个进行中的请求 — 并在稍后一次性处理所有这些请求。一旦组合的 dispose() 方法被调用,任何试图添加另一个 Disposable 的尝试都会立即处理它。
4.3.3. Lambda的替代方案:BaseSubscriber
另外还有一个更通用的 subscribe 方法,它接受一个完整的 Subscriber,而不是用lambda组成一个。为了帮助编写这样的 Subscriber,我们提供了一个名为 BaseSubscriber 的可扩展类。
BaseSubscriber(或其子类)的实例是 单一用途,这意味着,如果一个 BaseSubscriber 订阅了第二个 Publisher,则会取消对第一个 Publisher 的订阅。这是因为使用一个实例两次违反了响应式流的规则,即 Subscriber 的 onNext 方法必须不能被并行调用。因此,只有在对 Publisher#subscribe(Subscriber) 的调用中直接声明匿名实现时,匿名实现才是不错的。
|
现在我们可以实现其中的一个。我们称之为 SampleSubscriber。下面的例子显示了如何将其附加到 Flux:
SampleSubscriber<Integer> ss = new SampleSubscriber<Integer>();
Flux<Integer> ints = Flux.range(1, 4);
ints.subscribe(i -> System.out.println(i),
    error -> System.err.println("Error " + error),
    () -> {System.out.println("Done");},
    s -> s.request(10));
ints.subscribe(ss);
下面的例子显示了 SampleSubscriber 作为 BaseSubscriber 的简约实现的样子:
package io.projectreactor.samples;

import org.reactivestreams.Subscription;

import reactor.core.publisher.BaseSubscriber;

public class SampleSubscriber<T> extends BaseSubscriber<T> {

	public void hookOnSubscribe(Subscription subscription) {
		System.out.println("Subscribed");
		request(1);
	}

	public void hookOnNext(T value) {
		System.out.println(value);
		request(1);
	}
}
SampleSubscriber 类扩展了 BaseSubscriber,在Reactor中,它作为用户自定义的 Subscribers 的推荐抽象类。这个类提供了可以被重载并以此来调整订阅者行为的钩子。默认情况下,它会触发一个无界的请求,且行为方式与 subscribe() 完全相同。然而,当你想要一个自定义请求数量时,扩展一个 BaseSubscriber 会更有用。
对于一个自定义请求数量,最起码是像我们一样实现 hookOnSubscribe(Subscription subscription) 和 hookOnNext(T value)。在我们的例子中,hookOnSubscribe 方法打印一条语句到标准输出并发出第一个请求。然后 hookOnNext 方法打印一条语句并执行其它的请求,每次一个请求。
SampleSubscriber 类产生以下输出:
Subscribed
1
2
3
4
BaseSubscriber 还提供了一个 requestUnbounded() 方法来切换到无界模式(相当于 request(Long.MAX_VALUE)),以及一个 cancel() 方法。
它还具有其它钩子:hookOnComplete,hookOnError,hookOnCancel,和 hookFinally(总是在序列终止时被调用,终止类型作为 SingalType 参数传递)。
你几乎肯定要实现 hookOnError,hookOnCancel,和 hookOnComplete 方法。你可能还想实现 hookFinally 方法。SampleSubscribe 是 执行有界请求 的 Subscriber 的绝对最小实现。
|
4.3.4. 关于背压和调整请求的方法
在Reactor中实现背压时,通过向上游操作符发送 request,将消费者的压力传回到源端。当前请求的总和有时被称为当前 “需求”,或者 “等待的请求”。
请求的上限为 Long.MAX_VALUE,表示为无限制的请求(意思是"`尽可能快的生产`" — 基本上是禁用了背压)。
第一个请求来自于订阅时的最终订阅者,然而最直接的订阅方式都会立即触发一个 Long.MAX_VALUE 的无界请求:
-
subscribe()和大多数基于lambda的形式(具有 Consumer<Subscription> 的除外) -
block(),blockFirst()和blockLast() -
在
toIterable()或toStream()上迭代
自定义原始请求最简单的方法是使用重写了 hookOnSubscribe 方法的 BaseSubscriber 来 subscribe,如下例所示:
Flux.range(1, 10)
    .doOnRequest(r -> System.out.println("request of " + r))
    .subscribe(new BaseSubscriber<Integer>() {

      @Override
      public void hookOnSubscribe(Subscription subscription) {
        request(1);
      }

      @Override
      public void hookOnNext(Integer integer) {
        System.out.println("Cancelling after having received " + integer);
        cancel();
      }
    });
前面的代码片段打印出以下内容:
request of 1
Cancelling after having received 1
在处理一个请求时,你必须小心产生足够的需求以使序列前进,否则Flux可能会被 “卡住”。这就是为什么 BaseSubscriber 在 hookOnSubscribe 默认为无限的请求。当重写这个钩子时,你通常应该至少调用一次 request。
|
改变下游请求的操作符
有一点要记住的是,在订阅层表达的请求 可以 被上游链中的每个操作符重新调整。一个范例就是 buffer(N) 操作符:如果它接收到 request(2),则解释为需要 两个完整缓冲区。因此,由于缓冲区需要 N 个元素才能被视为已满足请求,因此 buffer 操作符将请求重新调整为 2 x N。
你可能还注意到有些操作符采用名为 prefetch 的 int 输入参数的形式。这是另一类修改下游请求的操作符。它们通常用于处理内部序列,从输入的每个元素(如 flatMap)中派生出 Publisher。
Prefetch 是对这些内部序列发出的初始请求进行调整的一种方法。如果未指定,这些操作符大多都以 32 的需求开始。
这些操作符通常还实现了 补充优化:一旦操作符看到75%的预取请求已完成,它将从上游重新请求75%。这是一种启发式优化,使这些操作符能够主动预测即将到来的请求。
最后,有两个操作符可以让你直接调整请求:limitRate 和 limitRequest。
limitRate(N) 对下游请求进行拆分,以便将其分批次向上游传播。例如,对 limitRate(10) 发出 100 的请求会导致最多 10 个请求,分为 10 个批次传播到上游。注意,在这种形式下,limitRate 实际上实现了前面讨论的补充优化。
该操作符有一个可以让你调整补充数量(称为 lowTide)的形式:limitRate(highTide, lowTide)。选择 lowTide 为 0 将导致 严格的 批次 highTide 请求,而不是由补充策略进一步调整批次。
另一方面,limitRequest(N) 限制 将下游请求的最大请求量。它将请求累加到 N。如果单个 request 没有超过总的请求 N,则该特定请求将完全传播到上游。在源发出该请求量后,limitRequest 将序列视为已完成,向下游发送 onComplete 信号,并取消源。
4.4. 以编程方式创建序列
在这一节中,我们将通过以编程方式定义其关联的事件(onNext,onError,和 onComplete)来介绍 Flux 或 Mono 的创建。所有这些方法都有一个共同点,即它们暴露了一个API来触发我们称之为 sink 的事件。实际上有一些sink的形式,稍后我们将介绍。
4.4.1. 同步 generate
Flux 的最简单的编程创建形式是通过具有生成器功能的 generate 方法。
这用于 synchronous 和 一对一 发射,这意味着该sink是一个 SynchronousSink,并且每次回调调用最多只能调用其 next() 方法一次。然后你可以另外调用 error(Throwable) 或 complete(),但这是可选的。
最有用的形式可能是一种能让你保留一个状态,你可以在你sink的使用中参考这个状态来决定下一步发出什么。然后生成器函数变成了 BiFunction<S, SynchronousSink<T>, S>,其中 <S> 是状态对象的类型。你必须为初始状态提供一个 Supplier<S>,你的生成器函数现在每轮都会返回一个新的状态。
例如,你可以使用 int 作为状态:
generate 的示例Flux<String> flux = Flux.generate(
() -> 0, (1)
(state, sink) -> {
sink.next("3 x " + state + " = " + 3*state); (2)
if (state == 10) sink.complete(); (3)
return state + 1; (4)
});| 1 | 我们提供初始的状态值为0。 |
| 2 | 我们用状态来选择要发出什么(3的乘法表中的一行)。 |
| 3 | 我们还可以用它来选择什么时候停止。 |
| 4 | 我们返回一个新的状态,在下一个调用中使用(除非这个序列在这个调用中终止)。 |
前面的代码生成3的乘法表,如下所示:
3 x 0 = 0
3 x 1 = 3
3 x 2 = 6
3 x 3 = 9
3 x 4 = 12
3 x 5 = 15
3 x 6 = 18
3 x 7 = 21
3 x 8 = 24
3 x 9 = 27
3 x 10 = 30
你还可以使用可变的 <S>。例如,上面的例子可以使用一个单独的 AtomicLong 作为状态来重写,在每一轮对其进行修改:
Flux<String> flux = Flux.generate(
    AtomicLong::new, (1)
    (state, sink) -> {
      long i = state.getAndIncrement(); (2)
      sink.next("3 x " + i + " = " + 3*i);
      if (i == 10) sink.complete();
      return state; (3)
});| 1 | 这次,我们生成一个可变的对象作为状态。 |
| 2 | 我们在这里改变状态。 |
| 3 | 我们返回 相同 实例作为新状态。 |
如果你的状态对象需要清理一些资源,请使用 generate(Supplier<S>, BiFunction, Consumer<S>) 形式来清理最后的状态实例。
|
下面的例子使用来包含一个 Consumer 的 generate 方法:
Flux<String> flux = Flux.generate(
    AtomicLong::new,
      (state, sink) -> { (1)
      long i = state.getAndIncrement(); (2)
      sink.next("3 x " + i + " = " + 3*i);
      if (i == 10) sink.complete();
      return state; (3)
    }, (state) -> System.out.println("state: " + state)); (4)
}| 1 | 同样,我们生成一个可变对象作为状态。 |
| 2 | 我们在这里改变状态。 |
| 3 | 我们返回 相同 实例作为新状态。 |
| 4 | 我们把最后一个状态值(11)视为这个 Consumer lambda的输出。 |
在包含数据库连接或其他资源的状态需要在进程结束时处理的情况下,Consumer lambda可以关闭连接或以其它方式处理任何应在进程结束时完成的任务。
4.4.2. 异步和多线程:create
create 是一种更高级的编程方式创建 Flux 的形式,它适合每轮多次发出,甚至来自多个线程。
它暴露了一个 FluxSink 及其 next,error 和 complete 方法。与 generate 相反,它没有基于状态的形式。但是,它可以在回调中触发多线程事件。
create 将现有的API和响应式世界桥接起来非常有用 - 例如基于监听器的异步API。
|
create 不能使你的代码并行化你,也不能使其异步化,即使它 可以 与异步API一起使用。如果在 create lambda中阻塞了,则会使自己陷入死锁和类似副作用中。即使使用了 subscribeOn,也需要警惕,即长时间阻塞的 create lambda(比如无限循环的调用 sink.next(t))会锁住管道:这些请求永远不会执行,因为循环会耗尽应运行它们的线程。使用 subscribeOn(Scheduler, false) 的形式:requestOnSeparateThread = false 将使用 Scheduler 线程来进行 create,并且仍然可以通过在原始的线程中执行 request 来让数据流动。
|
假设你使用了基于监听器的API。它按块处理数据,并有两个事件:(1)数据块已准备就绪;(2)处理已完成(终止事件),如 MyEventListener 接口所示:
interface MyEventListener<T> {
    void onDataChunk(List<T> chunk);
    void processComplete();
}
你可以使用 create 将其桥接成 Flux<T> 中:
Flux<String> bridge = Flux.create(sink -> {
    myEventProcessor.register( (4)
      new MyEventListener<String>() { (1)

        public void onDataChunk(List<String> chunk) {
          for(String s : chunk) {
            sink.next(s); (2)
          }
        }

        public void processComplete() {
            sink.complete(); (3)
        }
    });
});| 1 | 桥接到 MyEventListener API |
| 2 | 块中的每个元素都会成为 Flux 中的一个元素。 |
| 3 | processComplete 事件被转换为 onComplete。 |
| 4 | 所有这些都是在 myEventProcessor 执行时异步完成的。 |
此外,由于 create 可以桥接异步API并管理背压,所以你可以通过声明 OverflowStrategy 来细化背压的行为:
-
IGNORE完全忽略下游背压请求。当下游队列满时,可能会产生IllegalStateException。 -
ERROR当下游无法跟上时,发出IllegalStateException信号。 -
DROP如果下游还没有准备好接收信号,则丢弃传入的信号。 -
LATEST让下游只能获得来自上游的最新信号。 -
BUFFER(默认值)在下游无法跟上时,缓冲所有的信号(这将无限制的缓冲,可能会导致OutOfMemoryError)。
Mono 也有一个 create 生成器。Mono 创建的 MonoSink 不允许多次发出。它将在第一个信号之后丢弃所有信号。
|
4.4.3. 异步单线程:push
push 介于 generate 和 create 之间,适用于处理来自单个生产者的事件。从某种意义上说,它类似于 create,因为它也可以是异步的,并且可以使用 create 所支持的任何溢出策略来管理背压。但是,只能有一个生产线程 可以调用 next,complete 或者 error。
Flux<String> bridge = Flux.push(sink -> {
    myEventProcessor.register(
      new SingleThreadEventListener<String>() { (1)

        public void onDataChunk(List<String> chunk) {
          for(String s : chunk) {
            sink.next(s); (2)
          }
        }

        public void processComplete() {
            sink.complete(); (3)
        }

        public void processError(Throwable e) {
            sink.error(e); (4)
        }
    });
});| 1 | 桥接到 SingleThreadEventListener API。 |
| 2 | 使用单个监听器线程中的 next 将事件推送到 sink。 |
| 3 | 由同一监听器线程生成的 complete 事件。 |
| 4 | error 事件也是由同一监听器线程生成的。 |
混合式推/拉模型
大多数响应式操作符,比如 create,都遵循混合的 推/拉 模型。我们的意思是,尽管大多数处理都是异步的(建议使用 推 方法),但也有一个小的 拉 组件:请求。
从源来看,消费者从源 拉 数据,直到第一次请求之前,它不会发出任何东西。只要有可用的数据时,源会向消费者 推 送数据,但会在其请求数量的范围内。
注意,push() 和 create() 都允许设置一个 onRequest 消费者,以便于管理请求量,并确保只有当有待处理的请求时,才将数据推送到sink中。
Flux<String> bridge = Flux.create(sink -> {
    myMessageProcessor.register(
      new MyMessageListener<String>() {

        public void onMessage(List<String> messages) {
          for(String s : messages) {
            sink.next(s); (3)
          }
        }
    });
    sink.onRequest(n -> {
        List<String> messages = myMessageProcessor.getHistory(n); (1)
        for(String s : message) {
           sink.next(s); (2)
        }
    });
});| 1 | 请求时轮询消息。 |
| 2 | 如果消息立即可用,将其推送到接收器。 |
| 3 | 稍后异步到达的其余消息也将被传递。 |
在 push() 或 create() 之后清理
两个回调,onDispose 和 onCancel,在取消或终止时执行任何清理。onDispose 可用于 Flux 完成、错误或取消时执行清理。onCancel 可以用于在使用 onDispose 执行清理之前,执行任何特定于取消的操作。
Flux<String> bridge = Flux.create(sink -> {
    sink.onRequest(n -> channel.poll(n))
        .onCancel(() -> channel.cancel()) (1)
        .onDispose(() -> channel.close())  (2)
});| 1 | onCancel 首先被调用,仅用于取消信号。 |
| 2 | 完成、错误或取消信号时调用 onDispose。 |
4.4.4. 处理
handle 方法有点不同:它是一个实例方法,意味着它被链接到一个现有的源(就像常见的操作符)上。它存在于 Mono 和 Flux 中。
它靠近于 generate,从某种意义上说,它使用 SynchronousSink 并只允许逐个的发出。但是,handle 可以用来从每个源元素中生成一个任意值,可能会跳过一些元素。这样,它可以作为 map 和 filter 的组合。handle的方法签名如下:
Flux<R> handle(BiConsumer<T, SynchronousSink<R>>);让我们考虑一个例子。响应式流规范不允许序列中的值为 null。但是你想使用一个预先存在的方法作为map函数来执行 map,而该方法有时返回null怎么办?
例如,下面的方法可以安全地应用于整数源:
public String alphabet(int letterNumber) {
	if (letterNumber < 1 || letterNumber > 26) {
		return null;
	}
	int letterIndexAscii = 'A' + letterNumber - 1;
	return "" + (char) letterIndexAscii;
}
然后,我们可以使用 handle 来删除任何空值:
handle 用于 "映射和消除null值" 的场景Flux<String> alphabet = Flux.just(-1, 30, 13, 9, 20)
.handle((i, sink) -> {
String letter = alphabet(i); (1)
if (letter != null) (2)
sink.next(letter); (3)
});
alphabet.subscribe(System.out::println);| 1 | 映射到字母。 |
| 2 | 如果 “map函数” 返回null…. |
| 3 | 通过不调用 sink.next 来过滤掉它。 |
将打印出:
M
I
T
4.5. 线程和调度器
Reactor,就像RxJava一样,可以被认为是 可并发的。也就是说,并没有强制的并发模型。相反,它让开发人员掌握主动权。然而这并不妨碍框架帮你解决并发问题。
获得 Flux 或 Mono 并不一定意味着它要在特定的线程运行。相反,大多数操作符继续在上一个操作符执行的 Thread 中工作。除非指定,否则最上面的操作符(源)本身运行在调用了 subscribe() 的 Thread 上。下面的示例在一个新的线程上运行 Mono:
public static void main(String[] args) throws InterruptedException {
  final Mono<String> mono = Mono.just("hello "); (1)

  Thread t = new Thread(() -> mono
      .map(msg -> msg + "thread ")
      .subscribe(v -> (2)
          System.out.println(v + Thread.currentThread().getName()) (3)
      )
  )
  t.start();
  t.join();

}| 1 | Mono<String> 在 main 线程中组装。 |
| 2 | 但是,它是在 Thread-0 线程中订阅的。 |
| 3 | 因此,map 和 onNext 回调实际都是在 Thread-0 中运行。 |
上面的代码产生以下输出:
hello thread Thread-0在Reactor中,执行模型和执行的位置由使用的 Scheduler 决定。
Scheduler具有类似于 ExecutorService 的调度职责,但有一个专门的抽象使其可以做更多的事情,尤其是作为一个时钟和更广的范围实现(虚拟时间测试,波动或立即调度等)。
The Schedulers
类有可以访问执行上下文的静态方法:
-
无执行上下文(
Schedulers.immediate()):在处理时,提交的Runnable将被直接执行,有效地在当前的Thread上运行它们(可以视为“空对象”或无操作的Scheduler)。 -
一个单一可重用的线程(
Schedulers.single())。注意,此方法对所有调用者会重用相同的线程,直到调度器销毁掉。如果你希望每次调用都有一个特定的线程,请使用Schedulers.newSingle()即可。 -
一个无界的弹性线程池(
Schedulers.elastic())。由于Schedulers.boundedElastic()的引入,这个线程池不再是首选的了,因为它容易隐藏背压问题而导致线程过多(见下文)。 -
一个有边界的弹性线程池(
Schedulers.boundedElastic())。就像它的前身elastic()一样,它根据需要创建新的和复用空闲的线程池。空闲时间过长(默认值为60s)的线程池也会被销毁。与之前的elastic()不同的是,创建可支持的线程数有上限(默认为CPU核数 x 10)。最多可提交10万个任务,达到上限后,将在线程可用时重新调度任务(当延时调度时,延迟在线程可用时开始)。对于I/O阻塞任务,这是更好的选择。Schedulers.boundedElastic()是一种在自己线程上进行阻塞处理的便捷方式,它不会占用其它的资源。见如何包装一个同步阻塞调用?,但不会给系统带来太多新的线程压力。 -
一个固定worker池,调整为并行工作(
Schedulers.parallel())。它创建和CPU核数相等的worker。
此外,你可以用现有的 ExecutorService 通过 Schedulers.fromExecutorService(ExecutorService) 创建一个 Scheduler。(你也可以使用 Executor 进行创建,但不建议这样做。)
你也可以通过使用 newXXX 方法创建各种调度器类型的新实例。例如,Schedulers.newParallel(yourScheduleName) 创建了一个新的并行调度器,命名为 yourScheduleName。
|
虽然 通过创建实现 |
一些操作符默认使用 Schedulers 中特定的调度器(通常会给你提供一个不同的调度器)。例如,调用 Flux.interval(Duration.ofMillis(300)) 工厂方法会每隔300ms产生一个 Flux<Long>。默认情况下,这是由 Schedulers.parallel() 启用的。下面这一行将调度器改为类似于 `Schedulers.single()`的新实例。
Flux.interval(Duration.ofMillis(300), Schedulers.newSingle("test"))Reactor提供了两种方式来切换响应式链中的执行上下文(或 Scheduler ): publishOn 和 subscribeOn。两者都取一个 Scheduler,并让你将执行上下文切换到该调度器。但是 publishOn 在链中的位置是很重要的,然而 subscribeOn 的位置却是无关紧要的。要理解这个区别,你首先要记住订阅之前什么都不会发生。
在Reactor中,当你用链接操作符时,你可以根据需要在内部封装尽可能多的 Flux 和 Mono 实现。一旦你订阅了,一个 Subscriber 对象的链就会创建出来,向后(沿着链向上)到第一个生产者。这实际上是对你隐藏掉的。你能看到的只是外层到 Flux (或 Mono)和 Subscription,但是这些中间的操作符的订阅才是真正的工作。
有了这些知识,我们可以仔细看看 publishOn 和 subscribeOn 操作符:
4.5.1. publishOn 方法
和其它操作符一样,publishOn 应用在订阅链的中间位置。它接收来自上游的信号,并在下游重放,同时在相关的 Scheduler 中某个worker执行回调。因此它 影响到后续操作符的执行(直到链中的另一个 publishOn ),具体如下:
-
将执行上下文改为由
Scheduler选择的一个Thread -
根据规范,
onNext依次调用,所以这就占用了一个线程 -
除非它们在特定的
Scheduler上工作,否则在publishOn之后的操作符将继续在同一线程上执行
下面的示例使用了 publishOn 方法:
Scheduler s = Schedulers.newParallel("parallel-scheduler", 4); (1)

final Flux<String> flux = Flux
    .range(1, 2)
    .map(i -> 10 + i)  (2)
    .publishOn(s)  (3)
    .map(i -> "value " + i);  (4)

new Thread(() -> flux.subscribe(System.out::println)); (5)| 1 | 创建一个包含四个 Thread 实例的新的 Scheduler。 |
| 2 | 第一个 map 操作符在<5>的匿名线程中执行。 |
| 3 | publishOn 将整个序列切换到从<1>中的 Thread 上。 |
| 4 | 第二个 map 操作符在<1>的 Thread 上运行。 |
| 5 | 这个匿名 Thread 是发生 订阅 地方,打印是在最近的执行上下文中发生的,也就是 publishOn 中的那个。 |
4.5.2. subscribeOn 方法
当向下的链被构造时,subscribeOn 应用在订阅处理上。因此,无论你将 subscribeOn 放在链中的哪个位置,始终会影响到源排放的上下文。然而,这不会影响到后续调用 publishOn 的行为 — 它们仍将为其之后的链执行上下文切换。
-
改变 整个链 所订阅的
Thread -
从
Scheduler选择一个线程
只有链中的最早的 subscribeOn 调用才会被实际考虑在内。
|
下面的例子使用了 subscribeOn 方法:
Scheduler s = Schedulers.newParallel("parallel-scheduler", 4); (1)

final Flux<String> flux = Flux
    .range(1, 2)
    .map(i -> 10 + i)  (2)
    .subscribeOn(s)  (3)
    .map(i -> "value " + i);  (4)

new Thread(() -> flux.subscribe(System.out::println)); (5)| 1 | 创建一个包含四个 Thread 实例的新的 Scheduler。 |
| 2 | 第一个 map 操作符运行在四个线程中之一… |
| 3 | …因为 subscribeOn 从订阅时间(<5>)开始就会切换整个序列。 |
| 4 | 第二个 map 也运行在相同的线程上。 |
| 5 | 这个匿名的 Thread 是最初发生 _订阅_的地方,但 subscribeOn 立即将其转移到调度器的四个线程之一。 |
4.6. 错误处理
| 快速查看关于错误处理的操作符,参看相关操作符决策树。 |
在响应式流中,错误是终止事件。一旦错误发生,就会停止序列,并沿着操作符链向下传播到最后一步,即你定义的 Subscriber 及其 onError 方法。
此类错误仍应在应用程序层面处理。例如,你可以在UI中显示错误通知或者在REST端点中发送一个有意义的错误负载。因此,订阅者的 onError 方法应该总是被定义的。
如果没有定义,onError 会抛出一个 UnsupportedOperationException 异常。你可以使用 Exceptions.isErrorCallbackNotImplemented 方法进一步检测和分类。
|
Reactor还提供了处理链中间处理错误的替代方法,即错误操作符,下面的例子显示了如何做到这一点:
Flux.just(1, 2, 0)
    .map(i -> "100 / " + i + " = " + (100 / i)) //这将触发一个0的错误
    .onErrorReturn("Divided by zero :("); // 错误处理例子
在学习错误处理操作符之前,你必须记住 响应式序列中的任何错误都是一个终止事件。即使使用了错误处理操作符,它也不会让原来序列继续进行。相反,它将 onError 信号转换为一个新的序列(降级序列)的开始。换句话说,它会替换了 上游 终止序列。
|
现在我们可以逐一考虑每一种错误处理的方式。适当的时候,我们将与命令式编程的 try 模式并行使用。
4.6.1. 错误处理操作符
你可能对用try-catch块捕获异常的几种方法比较熟悉。 最值得注意的是,这些方法包含以下几种:
-
捕获并返回一个静态默认值。
-
捕获异常并执行一个降级方法。
-
捕获异常并动态地计算一个降级的值。
-
捕获异常,封装成一个
BusinessException,然后重新对外抛出。 -
捕获异常,打印错误的具体信息,并重新对外抛出异常。
-
使用
finally块或Java 7以上支持的 “try-with-resource” 语法清理资源。
Reactor中,所有的这些方法都以错误处理操作符的形式且具有相同的效果。 在深入这些操作符之前,我们首先要在响应式链和try-catch块之间建立对应的关系。
当订阅时,在链的末端的 onError 回调类似于一个 catch 块。在这里,当抛出一个 Exception 时,执行会跳转到catch,如下面示例所示:
Flux<String> s = Flux.range(1, 10)
    .map(v -> doSomethingDangerous(v)) (1)
    .map(v -> doSecondTransform(v)); (2)
s.subscribe(value -> System.out.println("RECEIVED " + value), (3)
            error -> System.err.println("CAUGHT " + error) (4)
);| 1 | 执行了可能引发异常的转换。 |
| 2 | 如果一切顺利,则执行第二次转换。 |
| 3 | 每个成功转换的值都会打印出来。 |
| 4 | 当发生错误时,终止序列且显示错误信息。 |
前面的例子在概念上与下面的try-catch块类似:
try {
    for (int i = 1; i < 11; i++) {
        String v1 = doSomethingDangerous(i); (1)
        String v2 = doSecondTransform(v1); (2)
        System.out.println("RECEIVED " + v2);
    }
} catch (Throwable t) {
    System.err.println("CAUGHT " + t); (3)
}| 1 | 如果这里出现异常 |
| 2 | …跳过循环的其余部分… |
| 3 | … 直接执行到这里。 |
既然我们已经建立了对应的关系,我们就可以看不同的错误处理情况及其等效的操作符。
静态降级的值
onErrorReturn 等效于“捕获并返回一个静态默认值”。
下面的例子显示了如何使用它:
try {
  return doSomethingDangerous(10);
}
catch (Throwable error) {
  return "RECOVERED";
}
下面的例子展示了在Reactor中相同的效果:
Flux.just(10)
    .map(this::doSomethingDangerous)
    .onErrorReturn("RECOVERED");
你还可以选择在异常上应用一个 Predicate 来决定是否恢复,如下面的例子所示:
Flux.just(10)
    .map(this::doSomethingDangerous)
.onErrorReturn(e -> e.getMessage().equals("boom10"), "recovered10"); (1)| 1 | 仅当异常信息为 "boom10" 时返回 |
降级方法
如果你想要有多个默认值,并且有其他的(更安全的)方式处理数据,你可以使用 onErrorResume。这相当于 “捕获异常并执行一个降级方法”。
例如,如果你名义上的进程正在从外部且不可靠的服务中获取数据,但你也保留了一个相同数据的本地缓存,而这些数据 也许 有点过期但是更可靠,你可以做以下操作:
String v1;
try {
  v1 = callExternalService("key1");
}
catch (Throwable error) {
  v1 = getFromCache("key1");
}

String v2;
try {
  v2 = callExternalService("key2");
}
catch (Throwable error) {
  v2 = getFromCache("key2");
}
下面的例子展示了在Reactor中相同的效果:
Flux.just("key1", "key2")
    .flatMap(k -> callExternalService(k) (1)
        .onErrorResume(e -> getFromCache(k)) (2)
);| 1 | 对于每个键,异步调用外部服务。 |
| 2 | 如果外部服务调用失败,降级获取该键的缓存中。注意,无论源的错误是什么 e 异常,我们总是应用相同的降级。 |
和 onErrorReturn 一样,onErrorResume 有不同的形式让你根据异常的类型或 Predicate 来过滤哪些异常需要降级。事实上,它需要一个 Function,这也让你可以根据遇到的不同的错误来选择不同的降级序列来进行切换。下面的例子显示了如何做到这一点:
Flux.just("timeout1", "unknown", "key2")
    .flatMap(k -> callExternalService(k)
        .onErrorResume(error -> { (1)
            if (error instanceof TimeoutException) (2)
                return getFromCache(k);
            else if (error instanceof UnknownKeyException)  (3)
                return registerNewEntry(k, "DEFAULT");
            else
                return Flux.error(error); (4)
        })
);| 1 | 该函数可以动态选择如何继续。 |
| 2 | 如果源超时,访问本地缓存。 |
| 3 | 如果源中该键为未知,则创建新的对象。 |
| 4 | 其它的所有情况下,“重新抛出异常”。 |
动态降级的值
即使你没有其它(更安全的)的数据处理的方式,你可能也想从你收到的异常中计算出一个降级的值。这就相当于 “捕获异常并动态地计算一个降级的值”。
例如,如果你的返回类型(MyWrapper)有一个专门用来保存异常的形式(参考 Future.complete(T success) 与 Future.completeExceptionally(Throwable error) ),你可以实例化错误保持变量并传递异常。
一个命令式编程示例如下所示:
try {
  Value v = erroringMethod();
  return MyWrapper.fromValue(v);
}
catch (Throwable error) {
  return MyWrapper.fromError(error);
}
使用 onErrorResume,你可以像降级方法解决方案以相同的方式进行响应式操作,略作修改,如下所示:
erroringFlux.onErrorResume(error -> Mono.just( (1)
        MyWrapper.fromError(error) (2)
));| 1 | 因为你期望 MyWrapper 来表示错误,所以你需要为 onErrorResume 获取一个 Mono<MyWrapper>,我们用 Mono.just() 来实现。 |
| 2 | 我们需要计算出异常值。这里,我们通过使用相关的 `MyWrapper`工厂方法对异常进行包装来实现。 |
捕获并重新抛出异常
"捕获异常,封装成一个 BusinessException,然后重新对外抛出”,在命令式编程里面看起来就像下面这样:
try {
  return callExternalService(k);
}
catch (Throwable error) {
  throw new BusinessException("oops, SLA exceeded", error);
}
在 “降级方法” 示例中, flatMap 中的最后一行给了我们一个提示,为我们实现同样的响应式操作,具体如下:
Flux.just("timeout1")
    .flatMap(k -> callExternalService(k))
    .onErrorResume(original -> Flux.error(
            new BusinessException("oops, SLA exceeded", original))
    );
但是,有一种更直接的方法,可以使用 onErrorMap 达到同样的效果:
Flux.just("timeout1")
    .flatMap(k -> callExternalService(k))
    .onErrorMap(original -> new BusinessException("oops, SLA exceeded", original));
侧面记录日志或响应
如果你想让错误继续传播,但仍想在不修改序列的情况下对错误做出响应(例如记录日志),你可以使用 doOnError 操作符。这相当于 “捕获异常,打印错误的具体信息,并重新对外抛出异常” 的模式,如下面的例子所示:
try {
  return callExternalService(k);
}
catch (RuntimeException error) {
  //make a record of the error
  log("uh oh, falling back, service failed for key " + k);
  throw error;
}
doOnError 操作符以及所有以 doOn 为前缀的操作符,有时被称为 “侧面效应”。它们让你可以在不修改序列事件的情况下窥测到序列内部的事件。
就像前面的命令式编程例子一样,下面的例子仍然会传播错误,但至少可以确保我们记录到外部服务发生了故障。
LongAdder failureStat = new LongAdder();
Flux<String> flux =
Flux.just("unknown")
    .flatMap(k -> callExternalService(k) (1)
        .doOnError(e -> {
            failureStat.increment();
            log("uh oh, falling back, service failed for key " + k); (2)
        })
        (3)
);| 1 | 可能失败的外部服务调用… |
| 2 | …被装饰了日志和统计的侧面效果… |
| 3 | …之后,它仍然以错误终止,除非我们在这里使用错误恢复操作符。 |
我们还可以设想,我们有统计计数器增加来作为第二个错误的侧面效应。
使用Resources和Fianlly块
最后一个与命令式编程对应的是清理,通过使用 “使用 finally 块” 或Java 7以上支持的 “try-with-resource” 语法清理资源,如下所示:
Stats stats = new Stats();
stats.startTimer();
try {
  doSomethingDangerous();
}
finally {
  stats.stopTimerAndRecordTiming();
}try (SomeAutoCloseable disposableInstance = new SomeAutoCloseable()) {
return disposableInstance.toString();
}两者都有对应的响应式操作:doFinally 和 using。
doFinally 是关于你希望在序列终止(用 onComplete 或 onError)时或被取消时执行的侧面作用。它给了你一个提示,说明是哪种类型的终止方式触发侧面作用的。下面的例子显示了如何使用 doFinally:
doFinally()Stats stats = new Stats();
LongAdder statsCancel = new LongAdder();
Flux<String> flux =
Flux.just("foo", "bar")
.doOnSubscribe(s -> stats.startTimer())
.doFinally(type -> { (1)
stats.stopTimerAndRecordTiming();(2)
if (type == SignalType.CANCEL) (3)
statsCancel.increment();
})
.take(1); (4)| 1 | doFinally 消费终止类型的 SignalType。 |
| 2 | 与 finally 代码块类似,我们总是记录时间。 |
| 3 | 这里我们也只在取消的情况下进行增量统计。 |
| 4 | take(1) 在发射一项元素后取消。 |
另一方面,using 处理了 Flux 来自于某资源的情况,且在处理过程中必须对资源进行操作。在下面的例子中,我们用 Disposable 替换 “try-with-resource” 中的 AutoCloseable 接口:
AtomicBoolean isDisposed = new AtomicBoolean();
Disposable disposableInstance = new Disposable() {
    @Override
    public void dispose() {
        isDisposed.set(true); (4)
    }

    @Override
    public String toString() {
        return "DISPOSABLE";
    }
};
现在我们可以做相当于 “try-with-resource” 的响应式操作了,看起来像下面这样:
using()Flux<String> flux =
Flux.using(
() -> disposableInstance, (1)
disposable -> Flux.just(disposable.toString()), (2)
Disposable::dispose (3)
);| 1 | 第一个lambda生成资源。这里,我们返回我们mock的 Disposable。 |
| 2 | 第二个lambda处理资源,返回一个 Flux<T>。 |
| 3 | 当第二步骤中 Flux 终止或被取消时,第三个lambda将被执行,以清理资源。 |
| 4 | 订阅并执行序列后,isDisposed 自动变成 true。 |
演示 onError 的终止方面
为了证明所有这些操作符都会在错误发生时导致上游原始序列终止,我们可以用一个更直观的例子 Flux.interval 来说明。 interval 操作符每x个时间单位周期增加 Long 值。下面的例子使用了 interval 操作符:
Flux<String> flux =
Flux.interval(Duration.ofMillis(250))
    .map(input -> {
        if (input < 3) return "tick " + input;
        throw new RuntimeException("boom");
    })
    .onErrorReturn("Uh oh");

flux.subscribe(System.out::println);
Thread.sleep(2100); (1)| 1 | 注意,interval 默认是在 timer Scheduler 上执行的。如果我们想在main类中运行该例子,我们需要在这里加一段 sleep 调用,这样应用程序不会在没有产生任何值的情况下立即退出。 |
前面的例子每250ms打印出一行,如下:
tick 0
tick 1
tick 2
Uh oh即使多了一秒的运行时间,interval 也没有多的周期。这个序列确实被错误终止了。
重试
关于错误处理,还有另外一个有趣的操作符,在上一节所述的情况下,你可能会想到使用它。 顾名思义,retry 让你重试产生错误的序列。
需要记住的是,它是通过 重新订阅 上游的 Flux 来工作的。实际上是一个不同的序列,原始序列仍然是终止的。为了验证这一点,我们依然用前面的例子,并添加 retry(1) 重试一次,而不是使用 onErrorReturn。下面的例子显示了如何做到这一点:
Flux.interval(Duration.ofMillis(250))
    .map(input -> {
        if (input < 3) return "tick " + input;
        throw new RuntimeException("boom");
    })
    .retry(1)
    .elapsed() (1)
    .subscribe(System.out::println, System.err::println); (2)

Thread.sleep(2100); (3)| 1 | elapsed 将每个值与前一个值发出后的持续时间关联起来。 |
| 2 | 我们还想看看什么时候出现 onError。 |
| 3 | 确保我们有足够的时间进行4x2的计时周期。 |
上面的例子产生以下输出:
259,tick 0
249,tick 1
251,tick 2
506,tick 0 (1)
248,tick 1
253,tick 2
java.lang.RuntimeException: boom| 1 | 从周期0,一个新的 interval 开始。额外的250ms的持续时间为从第四个周期开始,也就是导致异常和后续重试的那个周期。 |
从前面的例子可以看到,retry(1) 仅重新订阅了一次原始的 interval,从0开始重新计时。第二次,由于异常依然发生,放弃并向下游传播错误。
retry(称为 retryWhen)有一个更高级的版本,使用伴随的 Flux 来告知是否应重试特定的故障。为了便于自定义retry的条件,这个伴随的 Flux 被操作符创建但是是由用户自己组装的。
伴随的 Flux 是一个 Flux<RetrySignal> ,它被传递给一个 Retry 策略/函数,且作为 retryWhen 的唯一的参数提供。作为用户,你定义该函数并使其返回新的 Publisher<?>。Retry 类是一个抽象类,但如果你想用一个简单的lambda(Retry.from(Function))来转换伴随的对象,它提供了一个工厂方法。
重试周期如下:
-
每次发生错误时(提供重试的可能性),
RetrySignal都会被发送到伴随的Flux中,而这个Flux已经被你的函数装饰过了。这里的Flux可以看到目前为止所有的尝试。RetrySignal提供了对错误的访问,以及围绕错误的元数据。 -
如果伴随的
Flux产生一个值,则会发生重试。 -
如果伴随的
Flux完成,则错误被吞掉,重试循环停止,结果序列也完成。 -
如果伴随的
Flux产生一个错误(e),重试周期停止并产生带有错误(e)的序列。
前两种情况的区分很重要。只需完成伴随的就能有效地吞掉错误。考虑一下下面的方式,通过使用 retryWhen 来模仿 retry(3):
Flux<String> flux = Flux
    .<String>error(new IllegalArgumentException()) (1)
    .doOnError(System.out::println) (2)
    .retryWhen(Retry.from(companion -> (3)
companion.take(3))); (4)| 1 | 这会不断产生错误,调用重试。 |
| 2 | doOnError 可以让我们能够在重试之前记录和看到所有的失败。 |
| 3 | Retry 改编自一个非常简单的 Function lambda |
| 4 | 这里,我们认为前三个错误是可以重试的(take(3)),然后放弃。 |
实际上,前面的例子产生一个空的 Flux,但是它成功地完成了。由于在同一个 Flux 上地 retry(3) 会以最近的错误终止,所以这个 retryWhen 例子与 retry(3) 不完全相同。
要想达到同样的行为,还需要一些额外的技巧:
AtomicInteger errorCount = new AtomicInteger();
Flux<String> flux =
		Flux.<String>error(new IllegalArgumentException())
				.doOnError(e -> errorCount.incrementAndGet())
				.retryWhen(Retry.from(companion -> (1)
						companion.map(rs -> { (2)
							if (rs.totalRetries() < 3) return rs.totalRetries(); (3)
							else throw Exceptions.propagate(rs.failure()); (4)
						})
));| 1 | 我们通过改编 Function lambda来自定义 Retry,而不是提供一个具体的类。 |
| 2 | 伴随的对象发出 RetrySignal,它记录了迄今为止的重试次数和最后一次失败的次数。 |
| 3 | 为了允许三次重试,我们考虑索引<3并返回一个值来发出(这里我们简单地返回索引)。 |
| 4 | 为了在错误中终止序列,我们在这三次重试之后抛出原始异常。 |
人们可以用 Retry 中暴露的构建器来实现同样的功能,也可以使用更流畅的重试策略。例如:errorFlux.retryWhen(Retry.max(3));。
|
| 你可以用类似的代码来实现 “幂等补偿和重试” 模式,如FAQ中所示: |
core提供的 Retry 辅助工具,RetrySpec 和 RetryBackoffSpec,都允许进行高级定制,如:
-
为可以触发重试的异常设置
filter(Predicate) -
通过
modifyErrorFilter(Function)修改这样一个先前设置的过滤器 -
触发重试触发器(即延时前后的回退)等副作用,只要重试有效(
doBeforeRetry()和doAfterRetry()是附加的) -
在重试触发器周围触发一个异步的
Mono<Void>,它允许在基本的延迟的基础上添加异步行为,从而进一步延迟触发器(doBeforeRetryAsync和doAfterRetryAsync是附加的) -
在达到最大尝试次数的情况下,通过
onRetryExhaustedThrow(BiFunction)自定义异常。默认情况下,使用了Exceptions.retryExhausted(…),可以通过Exceptions.isRetryExhausted(Throwable)来区分。 -
激活处理 瞬时错误 (见下文)
Retry 规范中的瞬时错误处理使用 RetrySignal#totalRetriesInARow():为了检查是否重试和计算重试延迟,每次发出 onNext 时,使用的索引是一个替代索引且被重置为0。
这样做的后果是,如果重新订阅的数据源在再次失败之前产生了一些数据,那么之前的失败将不计入最大的重试次数。
在指数退避策略的情况下,这也意味着下一次的尝试将回到最小的 Duration 退避,而不是更长的时间。
这对于生存比较久的源来说尤其有用,因为这些源看到的是零星的错误突发(或 瞬时 错误),每次突发都应该用自己的回退来重试。
AtomicInteger errorCount = new AtomicInteger(); (1)
AtomicInteger transientHelper = new AtomicInteger();
Flux<Integer> transientFlux = Flux.<Integer>generate(sink -> {
	int i = transientHelper.getAndIncrement();
	if (i == 10) { (2)
		sink.next(i);
		sink.complete();
	}
	else if (i % 3 == 0) { (3)
		sink.next(i);
	}
	else {
		sink.error(new IllegalStateException("Transient error at " + i)); (4)
	}
})
		.doOnError(e -> errorCount.incrementAndGet());

transientFlux.retryWhen(Retry.max(2).transientErrors(true))  (5)
             .blockLast();
assertThat(errorCount).hasValue(6); (6)| 1 | 我们将统计重试序列中的错误数量。 |
| 2 | 我们 generate 一个有突发错误的源。当计数器达到10时,它将成功完成。 |
| 3 | 如果 transientHelper 原子变量是 3 的倍数时,我们就会发出 onNext,从而结束当前的突发错误。 |
| 4 | 在其他情况下,我们会发出一个 onError。这就是3次中的两次,所以2个 onError 突发错误中断了1个 onNext。 |
| 5 | 我们在该源上使用 retryWhen,配置最多为2次重试,但是以 transientErrors 模式。 |
| 6 | 在结束时,在 errorCount 中登记了 6 个错误后,序列到达 onNext(10) 并完成。 |
如果没有 transientErrors(true),在第二次突发错误时,将达到配置的最大尝试数 2,并且在发出 onNext(3) 后,序列将失败。
4.6.2. 处理操作符或者函数中的异常
一般来说,所有的操作符本身都可能包含有可能触发异常或调用用户自定义的回调的代码,这些代码同样可能会失败,所以它们都包含了某种形式的错误处理。
根据经验,未经过检查的异常总是通过 onError 进行传播。例如,在 map 函数中抛出一个 RuntimeException 转换为一个 onError,如下代码所示:
Flux.just("foo")
    .map(s -> { throw new IllegalArgumentException(s); })
    .subscribe(v -> System.out.println("GOT VALUE"),
               e -> System.out.println("ERROR: " + e));
前面的代码打印出以下内容:
ERROR: java.lang.IllegalArgumentException: foo
你可以通过使用钩子来调整在传递给 onError 之前的 Exception。
|
然而,Reactor定义了一组被认为是致命的异常(例如 OutOfMemoryError)。参考 Exceptions.throwIfFatal 方法。这些错误意味着Reactor不能继续运行,且将错误抛出而不是传播。
在内部,也有某些情况下,由于并发竞争,可能导致 onError 或 onComplete 条件,未检查的异常依然不能被传播(最明显的是在订阅和请求阶段)。当竞争发生时,不能传播的错误会被 “丢弃” 掉。这些情况在某种程度上也可以通过自定义钩子进行管理。参见删除钩子。
|
你可能会问:“需检查异常的怎么办?”
例如,如果你需要调用一些声明了 throws 异常的方法,你依然需要在 try-catch 块中处理这些异常。但是,你有几个选择:
-
捕获到异常并从中恢复。序列继续正常的进行。
-
捕获异常,将其封装成一个 不检查 的异常,然后将其抛出(中断序列)。
Exceptions工具类可以帮助你解决这个问题(接下来我们会讲到这个问题)。 -
如果你需要返回一个
Flux(例如,在flatMap中),那么就用一个产生错误的Flux来封装异常,如下所示:return Flux.error(checkedException)。(这个序列也会终止。)
Reactor有一个 Exceptions 工具类,你可以用它来确保只有当异常为被检查异常时才会被封装:
-
如果有必要的话,使用
Exceptions.propagate方法来封装异常。并且会首先调用throwIfFatal且不会封装RuntimeException。 -
使用
Exceptions.unwrap方法获取原始的未包装的异常(回到响应式特定异常的层次结构的根源)。
考虑下面的 map 的例子,它使用的转换方法可能导致 IOException 异常:
public String convert(int i) throws IOException {
    if (i > 3) {
        throw new IOException("boom " + i);
    }
    return "OK " + i;
}
假设你在 map 使用该方法。你现在必须显式的捕获到该异常,且你到map函数不能重新对外抛出。所以你可以将其作为 RuntimeException 异常传播到map的 onError 方法中,如下所示:
Flux<String> converted = Flux
    .range(1, 10)
    .map(i -> {
        try { return convert(i); }
        catch (IOException e) { throw Exceptions.propagate(e); }
    });
以后,当订阅前面的 Flux 并对错误做出响应时(例如在用户界面),如果你想对IO异常做一些特殊的事情,你可以将其还原到原始异常。下面的例子显示了如何做到这一点:
converted.subscribe(
    v -> System.out.println("RECEIVED: " + v),
    e -> {
        if (Exceptions.unwrap(e) instanceof IOException) {
            System.out.println("Something bad happened with I/O");
        } else {
            System.out.println("Something bad happened");
        }
    }
);
4.7. 处理器
Processor是一种特殊的 Publisher,也是 Subscriber。这意味着你可以 subscribe 一个 Processor(通常,它们实现了 Flux),但你也可以调用方法手动将数据注入到序列或终止它。
Processor有几种,每一种都有一些特殊的语义,但是在你开始研究它们之前,你需要问自己以下问题:
4.7.1. 我需要一个Processor吗?
大多数时候,你应该尽量避免使用 Processor。它们很难正确使用,而且容易出现一些极端的情况。
如果你认为 Processor 比较适合你的情况,请问你自己是否尝试过这两种选择:
-
操作符或者组合操作符是否满足要求?(看我需要哪个操作符?)
-
能否用 “generator” 操作符代替?(通常,这些操作符用于桥接非响应式的API,提供了一个概念上类似于
Processor的 “sink”,也就是说它允许你用数据手动填充或终止序列)。
如果在考察了上述的替代方案后,你仍然认为你需要一个 Processor,请阅读 可用处理器概述 章节了解不同的实现。
4.7.2. 使用 Sink 外观模式多线程安全生产
与其直接使用Reactor的 Processors,不如通过 一次性 调用 sink() 来获得 Processor 的 Sink。
FluxProcessor 接收器可以安全地关闭多线程生产者,并可以被多线程并发的生成数据的应用使用。例如,你可以通过以下操作为 UnicastProcessor 创建一个线程安全的序列化接收器:
UnicastProcessor<Integer> processor = UnicastProcessor.create();
FluxSink<Integer> sink = processor.sink(overflowStrategy);
多个生产者线程可以通过执行以下操作,在下面的序列化接收器上并发的生产数据:
sink.next(n);
尽管 FluxSink 适用于 Processor 的多线程 手动 输入,但不可能将订阅者方法和接收器方法混合使用:你必须将 FluxProcessor 订阅到源 Publisher 或者通过它的 FluxSink 手动输入。
|
从 next 溢出有两种可能的方式,这具体取决于 Processor 及其配置:
-
无界处理器通过丢弃或缓冲来处理溢出本身。
-
有界处理器在
IGNORE策略上阻塞或 “旋转”,或为sink指定的overflowStrategy行为。
4.7.3. 可用处理器概述
Reactor核心配备了几种 Processor。并非所有的处理器都有相同的语义,但是它们大致分为三类。以下列表简要介绍了这三类处理器:
-
直接的 (
DirectProcessor和UnicastProcessor):这些处理器只能通过用户直接操作(直接调用其Sink方法)来推送数据。 -
同步的(
EmitterProcessor和ReplayProcessor):这些处理器可以通过用户交互推送数据,也可以订阅上游的Publisher并同步消耗数据。
将事件发布到不同线程上的一种方法是将 EmitterProcessor 与 publishOn(Scheduler) 结合使用。例如,这可以取代以前的 TopicProcessor,在3.3.0中,它使用了 Unsafe 操作,并已被移到 reactor-extra。
|
直接的处理器
直接的 Processor 是一个可以向零个或多个 Subscribers 发送信号的处理器。最简单的实例化,只需要一个 DirectProcessor#create() 静态工厂方法。另一方面,它具有不处理背压的局限性。因此,如果你通过 DirectProcessor 推送了N个元素,但是如果有一个订阅者请求数量小于N,那么 DirectProcessor 就会向订阅者发送 IllegalStateException 的信号。
一旦 Processor 终止(通常是其接收器的 error(Throwable) 或者 complete() 方法被调用),它就会允许更多的订阅者订阅,但会立即将终止信号传播给它们。
单播处理器
单播 Processor 可以通过使用内部缓冲区来处理背压。不足之处是它最多只能有一个 Subscriber。
与直接处理器相比,UnicastProcessor 有更多的选项,这一点从几个 create 静态工厂的方法的存在可以反映出来。例如,默认情况下,它是无界的:如果在其 Subscriber 还没有请求数据的时候向它推送任何数量的数据,它将缓冲所有的数据。
你可以通过在 create 工厂方法中为内部缓冲区提供一个自定义的 Queue 实现来改变这一点。如果队列是有界的,那么当缓冲区满了,并且没有收到来自下游的足够请求时,处理器可能会拒绝数据的推送。
在这种 有界 的情况下,你也可以在处理器上建立一个回调,在每个被拒绝的元素上都会被调用,允许清理这些被拒绝的元素。
发射器处理器
一个发射器 Processor 可以发射给多个订阅者,同时为其每个订阅者提供背压。它还可以订阅到 Publisher 并同步转发其信号。
最开始,在它没有订阅者的时候,它仍然可以接收一些数据推送,最大为可配置的 bufferSize。此后,如果没有 Subscriber 订阅并消费数据,那么就会调用 onNext 块,直到处理器被耗尽为止(这只能同时发生)。
因此,第一个 Subscriber 在订阅时,最多接收到 bufferSize 个元素。但是,此后,处理器停止向其它订阅者重播这些信号。这些后续的订阅者只接受到在订阅后通过处理器推送的信号。内部缓冲区仍用于背压。
默认情况下,如果它的所有订阅者都被取消了(基本上意味着它们已经全部取消订阅),它将清除其内部缓冲区并停止接收新的订阅者。你可以通过使用 create 静态工厂方法中的 autoCancel 参数来对此进行调整。
重播处理器
重播 Processor 缓存了直接通过其 sink() 直接推送或来自上游 Publisher 的元素,并将其重播给后面的订阅者。
可以用多种配置来创建它:
-
缓存单个元素(
cacheLast)。 -
缓存一个有限的历史记录(
create(int))或 无界的历史记录(create())。 -
缓存基于时间的重播窗口(
createTimeout(Duration))。 -
缓存历史记录大小和时间窗口的组合(
createSizeOrTimeout(int, Duration))。
Suggest Edit to "Reactor核心特性"
5. Kotlin的支持
本节介绍了Reactor对Kotlin的支持。
5.1. 要求
Reactor支持Kotlin 1.1+,需要 kotlin-stdlib(或 kotlin-stdlib-jre7 或 kotlin-stdlib-jre8 其中之一)。
5.2. 扩展
|
从 因此,不推荐使用 |
得益于强大的 Java互操作性和 Kotlin扩展,Reactor的Kotlin API使用常规的Java API,并通过对一些Kotlin特有的API进行增强,这些API可以在Reactor中开箱即用。
记住必须要导入Kotlin扩展后才能使用。例如,这意味着只有在导入 import reactor.kotlin.core.publisher.toFlux 的情况下,Throwable.toFlux Kotlin扩展才能使用。也就是说,类似于静态导入,在大多数情况下,IDE应该会自动建议导入。
|
例如, Kotlin实化类型参数为JVM 泛型类型擦除提供了一个解决方案,且Reactor提供了一些扩展来利用这个特性。
下表比较了Java中的Reactor和Kotlin中的Reactor扩展。
Java |
Kotlin扩展 |
|
|
|
|
|
|
|
|
|
|
|
|
Reactor KDoc API列出并记录了所有可用的Kotlin扩展。
5.3. 空安全
Kotlin的关键特性之一是 空安全,它在编译时干净利落地处理了 null 值,而不是在运行时碰到著名的 NullPointerException 异常。通过可空性的声明和 “有值或者无值” 的语义表达可以使应用更加安全,而不需要花费代价进行诸如 Optional 这样的封装。(Kotlin允许使用具有空值的函数构造。请看 关于Kotlin空安全的全面指南。)
尽管Java不允许在其类型系统中表示null安全,但通过在 reactor.util.annotation 包中声明的友好的注释,Reactor为整个Reactor API提供空安全。默认情况下,Kotlin中使用的Java API中的类型会被识别为 平台类型,对于这些类型,空检查可以放宽。
Kotlin支持JSR 305注释 和Reactor可空性注释为Kotlin开发者提供了整个Reactor API的空安全,在编译时处理 null 相关问题的优势。
你可以通过添加 -Xjsr305 编译器标签来配置JSR 305的检查,并使用以下选项:-Xjsr305={strict|warn|ignore}。
对于Kotlin 1.1.50+的版本,默认行为与 -Xjsr305=warn 相同。strict 表示需要考虑Reactor API的完全空安全,但应该被认为是实验性的,因为Reactor API的可空性声明即使是在小的发行版之间也会发生演变,也可能会在未来增加更多的检查。
| 尚不支持泛型类型参数和变量参数,数组元素的可空性,但是应该会在即将发布的版本中出现。有关最新的信息,请看 此讨论。 |
Suggest Edit to "Kotlin的支持"
6. 测试
无论你是写了一个简单的Reactor操作符链还是自己的操作符,自动化测试都是一个不错的选择。
Reactor自带了一些专门用于测试的元素,汇总到自己的artifact:reactor-test。在 reactor-core 仓库中,你能够 在Github 找到该项目。
要在测试中使用它,你必须将其添加作为测试依赖。下面的例子显示了如何在Maven中怎么添加 reactor-test 作为依赖:
<dependencies><dependency>
<groupId>io.projectreactor</groupId>
<artifactId>reactor-test</artifactId>
<scope>test</scope>
(1)
</dependency>| 1 | 如果你使用了 BOM,你不需要指定 <version>。 |
下面的例子显示了如何在Gradle中添加 reactor-test 作为依赖:
dependencies 块dependencies {
testCompile 'io.projectreactor:reactor-test'
}reactor-test 的三个主要用途如下:
-
用
StepVerifier逐步测试一个序列是否遵循给定的场景。 -
生产数据,以便用
TestPublisher测试下游操作符(包括你自己的操作符)的行为。 -
在可以经过多个可选择的
Publisher的序列(例如,一个使用switchIfEmpty的链,进行Publisher的探测,以确保它已被使用(即已订阅)) 中。
6.1. 使用 StepVerifier 测试一个场景
测试Reactor序列最常见的情况是在你代码中定义了一个 Flux 或者 Mono(例如,可能是由一个方法返回的),想要测试它在订阅时的行为。
这种情况可以很好地转化为定义一个 “测试场景”,可以根据事件,一步步定义你的期望。你可能会问到并回答诸如下面的问题:
-
下一个预期的事件是什么?
-
你希望
Flux发射出一个特定的值? -
或者在接下来的300ms内什么都不做?
你可以通过 StepVerifier API来表达这一切。
例如,你可以在你的代码库中使用下面的工具方法来装饰一个 Flux:
public <T> Flux<T> appendBoomError(Flux<T> source) {
  return source.concatWith(Mono.error(new IllegalArgumentException("boom")));
}
为了测试它,你要验证以下场景:
我希望这个
Flux首先产生thing1,然后产生thing2,接着 产生带有错误消息 的boom。订阅并 验证 这些期望。
在 StepVerifier API中,这可以转化为以下测试:
@Test
public void testAppendBoomError() {
  Flux<String> source = Flux.just("thing1", "thing2"); (1)

  StepVerifier.create( (2)
    appendBoomError(source)) (3)
    .expectNext("thing1") (4)
    .expectNext("thing2")
    .expectErrorMessage("boom") (5)
    .verify(); (6)
}| 1 | 因为我们的方法需要一个源 Flux,所以定义一个简单的源来作为测试。 |
| 2 | 创建一个 StepVerifier 构建器,用于封装和验证 Flux。 |
| 3 | 传递要测试的 Flux(调用我们工具方法的结果)。 |
| 4 | 我们期望在订阅时产生的第一个信号是 onNext,值为 thing1。 |
| 5 | 我们期望的最后一个信号是以 onError 终止序列。这个异常应该包含 boom 信息。 |
| 6 | 重要的是通过调用 verify() 触发测试。 |
这个API是一个构建器。你首先创建 StepVerifier 并传递要测试的序列。这提供了一种方法选择,可以让你:
-
表达对下一个信号发生的期望。如果收到任何其他信号(或者信号的内容与预期不符),整个测试都会以一个有意义的
AssertionError失败。例如,你可以使用expectNext(T…)和expectNextCount(long)。 -
消费下一个信号。当你想要略过序列的一部分,或者想对信号的内容应用一个自定义的
assertion(例如,为了检测是否存在onNext事件并断言产生的列表元素个数大小为5),例如,你可以使用consumeNextWith(Consumer<T>)。 -
执行诸如暂停或运行任意代码等其他操作。例如,如果你想要操纵一个特定的测试状态或上下文。为此,你可以使用
thenAwait(Duration)和then(Runnable)。
对于终止事件,相应的期望方法(expectComplete() 和 expectError() 及其其它的形式)会切换到一个你无法再表达期望的API中。在这最后一步,你能做的就是再 StepVerifier 上执行一些额外的配置,然后触发验证,通常是用 verify() 或其其它形式之一。
此时, StepVerifier 订阅了被测试的 Flux 或 Mono,并触发序列的开始,将每一个新信号与场景中的下一个步骤进行比较。只要这些符合,测试就视为成功。一旦有一个差异,将会抛出 AssertionError 。
记住 verify() 步骤,它触发了验证。为了提供帮助,API包含了一些快捷方法,将终止期望与调用 verify() 结合起来: verifyComplete(),verifyError(),verifyErrorMessage(String) 等。
|
注意,如果其中一个基于lambda的期望抛出一个 AssertionError,则会按原样报告,测试失败。这对于自定义断言是很有用。
默认情况下,verify() 方法和派生的快捷方法(verifyThenAssertThat,verifyComplete() 等)没有超时时间。它们可以无限制地阻塞。你可以使用 StepVerifier.setDefaultTimeout(Duration) 为这些方法全局设置一个超时时间,或者用 verify(Duration) 指定一个超时。
|
6.1.1. 更好地识别测试失败
StepVerifier 提供了两个选项,以更好地确定是哪个期望步骤导致测试失败:
-
as(String):用在大多数expect*方法之后,用于给出先前期望的描述。如果期望失败,其错误信息会包含该描述。终止期望和verify不能使用该方式进行描述。 -
StepVerifierOptions.create().scenarioName(String):通过使用StepVerifierOptions来创建你的StepVerifier,你可以使用scenarioName方法为整个场景命名,这个名字也可用于在断言错误信息中。
注意,在两种情况下,只能保证在使用 StepVerifier 它们自己的方法产生的 AssertionError 信息中使用描述和名称(例如,手动抛出一个异常或通过 assertNext 中的断言库,则不会将描述或名称添加到错误消息中)。
6.2. 操纵时间
你可以使用基于时间的操作符的 StepVerifier 来避免相应的测试长时间的运行。你可以通过 StepVerifier.withVirtualTime 构建器来实现。
它看起来像下面这个例子:
StepVerifier.withVirtualTime(() -> Mono.delay(Duration.ofDays(1)))
//... 这里继续期望
这个虚拟时间的功能在Reactor的 Schedulers 工厂中插入一个自定义的 Scheduler。由于这些时间操作符通常使用默认的 Schedulers.parallel() 调度器,所以用 VirtualTimeScheduler 代替它就行了。但是,一个重要的前提是,这个操作符必须在虚拟时间调度器被激活后实例化。
为了增加这种情况正确发生的几率,StepVerifier 不接受简单的 Flux 作为输入。withVirtualTime 需要一个 Supplier,在完成调度器的设置后,它会缓慢地引导你创建被测试的Flux的实例。
请格外小心,确保在懒加载下 Supplier<Publisher<T>> 能被使用。否则,虚拟时间无法被保证。特别是避免在测试代码中 Flux 的过早实例化和并让 Supplier 返回该变量。相反,总是在lambda中实例化 Flux。
|
处理时间的期望方法有两种,不管有没有虚拟时间,都是有效的。
-
thenAwait(Duration):暂停步骤的计算(允许一些信号发生或延迟耗尽)。 -
expectNoEvent(Duration):也可以让序列在给定的持续时间内产生元素,但是如果在这段时间内有 其它 信号产生,则测试失败。
在经典模式下,这两种方法都会暂停线程的给定时间,而在虚拟模式下,则会提前虚拟时钟。
expectNoEvent 也将 subscription 视为一个事件。如果你把它作为第一步使用,通常会失败,因为会检测到订阅信号。用 expectSubscription().expectNoEvent(duration) 代替它。
|
为了快速计算我们上面的 Mono.delay 的行为,可以通过以下方式完成代码的编写:
StepVerifier.withVirtualTime(() -> Mono.delay(Duration.ofDays(1)))
    .expectSubscription() (1)
    .expectNoEvent(Duration.ofDays(1)) (2)
    .expectNext(0L) (3)
.verifyComplete(); (4)| 1 | 见前面的 tip。 |
| 2 | 期待一整天都不会有什么事情发生。 |
| 3 | 然后期待发射数据是 0。 |
| 4 | 然后期待完成(并触发验证)。 |
我们可以使用上面的 thenAwait(Duration.ofDays(1)),但 expectNoEvent 能够确保什么都不会过早发生。
注意,verify() 返回一个 Duration。这是整个测试的实时持续时间。
虚拟时间不是银弹。所有的 Schedulers 都是被替换为相同的 VirtualTimeScheduler。在某些情况下,你可以锁定验证过程,因为在期望表达前,虚拟时钟并未开始计时,从而导致在期望等待的数据只能提前产生。在大多数情况下,你需要将虚拟时钟提前,才能发出序列。无限序列的虚拟时间也会受到限制,这可能会占用序列和检测运行所在的线程。
|
6.3. 用 StepVerifier 执行执行后断言
在描述了你的场景中的最终期望后,你可以切换到一个补充的断言API,而不是触发 verify()。为此,你需要使用 verifyThenAssertThat()。
verifyThenAssertThat() 返回一个 StepVerifier.Assertions 对象,一旦整个场景成功地执行了,你可以使用它来断言一些状态元素(因为它同样会调用 verify())。典型(即高级)的用法是捕获被某些操作符丢弃的元素并断言它们(参见钩子章节)。
6.4. 测试 上下文
关于 上下文 的更多信息,请看为响应式序列添加上下文。
在 Context 的传播过程中,StepVerifier 附带一些期望:
-
expectAccessibleContext:返回一个ContextExpectations对象,你可以使用这个对象来设置在传播Context的期望。确保调用then()能够返回到序列期望集。 -
expectNoAccessibleContext:设置了一个期望,使其在被测试的操作符链上不能传播任何Context。这最有可能发生在当测试的不是响应式的Publisher或没有任何可以传播Context(例如,生成器源)的操作符
此外,你可以通过使用 StepVerifierOptions 来创建验证器,将特定于测试的初始 Context 关联到 StepVerifier。
下面的片段展示了这些特性:
StepVerifier.create(Mono.just(1).map(i -> i + 10),
				StepVerifierOptions.create().withInitialContext(Context.of("thing1", "thing2"))) (1)
		            .expectAccessibleContext() (2)
		            .contains("foo", "bar") (3)
		            .then() (4)
		            .expectNext(11)
.verifyComplete(); (5)| 1 | 通过使用 StepVerifierOptions 创建 StepVerifier 并传递一个初始化的 Context。 |
| 2 | 开始设置关于 Context 传播的期望。仅此一项就可以确保 Context 的传播。 |
| 3 | 特定 Context 期望的一个例子。它必须包含键 "thing1" 的值 "thing2"。 |
| 4 | 我们使用 then() 切换回对数据设置正常对期望。 |
| 5 | 让我们不要忘记对整个期望集合进行 verify()。 |
6.5. 用 TestPublisher 手动发射
对于更高级的测试用例来说,完全掌握数据源,能够触发精心选择的信号,使之与你要测试的特定情况紧密匹配会更有用。
另一种情况是当你已经实现了自己的操作符,想要验证其在关于响应式流规范的行为,特别是其源不能够很好表现时。
对于这两种情况,reactor-test 提供了 TestPublisher 类。这是一个能让你以编程方式触发各种信号的 Publisher<T>:
-
next(T)和next(T, T…)触发1到n个onNext信号。 -
emit(T…)触发1到n个onNext信号并执行complete()。 -
complete()以onComplete信号终止。 -
error(Throwable)以onError信号终止。
你可以通过 create 工厂方法获得一个表现良好的 TestPublisher。另外,你也可以通过使用 createNonCompliant 工厂方法创建一个表现不好的 TestPublisher。后者从 TestPublisher.Violation 枚举中取一个或多个值。这些值定义了生产者可以忽略规范中的哪些部分。这些枚举值包括:
-
REQUEST_OVERFLOW:允许在请求不足的情况下进行next调用,且不会触发IllegalStateException。 -
ALLOW_NULL:允许null值进行next调用而不会触发NullPointerException异常。 -
CLEANUP_ON_TERMINATE:允许连续多次发送终止信号。这包括complete()、error()和emit()。 -
DEFER_CANCELLATION:允许TestPublisher忽略取消信号并继续发送信号,就好像取消信号输掉了与所讲信号的比赛一样。
最后,TestPublisher 保持着订阅后的内部状态,可以通过它的各种 assert* 方法进行断言。
你可以使用转换方法 flux() 和 mono(),将其转换为 Flux 或 Mono。
6.6. 用 PublisherProbe 检查执行路径
在构造复杂的操作符链时,你可能会遇到有几个可能的执行途经,由不同的子序列具体化的情况。
大多数时候,这些子序列会产生一个特定的 onNext 信号,能够通过查看最终结果来断言其已执行。
例如,考虑下面的方法,它从源构建一个操作符链,如果源为空,则使用 switchIfEmpty 来回退到一个特定替代的源:
public Flux<String> processOrFallback(Mono<String> source, Publisher<String> fallback) {
    return source
            .flatMapMany(phrase -> Flux.fromArray(phrase.split("\\s+")))
            .switchIfEmpty(fallback);
}
你可以测试使用了switchIfEmpty的哪个逻辑分支,如下所示:
@Test
public void testSplitPathIsUsed() {
    StepVerifier.create(processOrFallback(Mono.just("just a  phrase with    tabs!"),
            Mono.just("EMPTY_PHRASE")))
                .expectNext("just", "a", "phrase", "with", "tabs!")
                .verifyComplete();
}

@Test
public void testEmptyPathIsUsed() {
    StepVerifier.create(processOrFallback(Mono.empty(), Mono.just("EMPTY_PHRASE")))
                .expectNext("EMPTY_PHRASE")
                .verifyComplete();
}
但是,想想看一个例子,该方法产生一个 Mono<Void>。它等待源完成,执行一个额外的任务并完成。如果源为空,必须执行类似于 Runnable 的降级任务。下面的例子显示了这种情况:
private Mono<String> executeCommand(String command) {
    return Mono.just(command + " DONE");
}

public Mono<Void> processOrFallback(Mono<String> commandSource, Mono<Void> doWhenEmpty) {
    return commandSource
            .flatMap(command -> executeCommand(command).then()) (1)
            .switchIfEmpty(doWhenEmpty); (2)
}| 1 | then() 忽略命令执行结果。它只关心它是否完成了。 |
| 2 | 如何区分两个都是空序列的情况? |
为了验证你的 processOrFallback 方法确实执行了 doWhenEmpty 分支,你需要写一些样板。即你需要一个 Mono<Void> :
-
捕获已经订阅的事实。
-
让你在整个过程结束 后 断言该事实。
在3.1版本之前,你需要为每个你想要断言的状态手动维护一个 AtomicBoolean,并将相应的 doOn* 回调附加到你需要评估的生产者上。当需要经常使用该模式时,这可能会有很多繁琐的模版。幸运的是,3.1.0引入了 PublisherProbe 的替代方案。下面的例子展示了如何使用它:
@Test
public void testCommandEmptyPathIsUsed() {
    PublisherProbe<Void> probe = PublisherProbe.empty(); (1)

    StepVerifier.create(processOrFallback(Mono.empty(), probe.mono())) (2)
                .verifyComplete();

    probe.assertWasSubscribed(); (3)
    probe.assertWasRequested(); (4)
    probe.assertWasNotCancelled(); (5)
}| 1 | 创建一个转换为空序列的探针。 |
| 2 | 通过调用 probe.mono() 让探针代替 Mono<Void>。 |
| 3 | 序列完成后,探针可断言它已被使用。你能检测它是否已被订阅… |
| 4 | …以及实际请求的数据… |
| 5 | …以及是否被取消。 |
你可以通过调用 .flux() 替换 .mono(),及让探针代替 Flux<T>。对于你想要探针执行途经并也需要探针发射数据的情况,你可以使用 PublisherProbe.of(Publisher) 来封装任何 Publisher<T>。
Suggest Edit to "测试"
7. 调试Reactor
从命令式同步编程范式切换到响应式异步范式编程有时会让人望而生畏。学习曲线中最陡峭的步骤之一,就是在出现问题时如何分析和调试。
在命令式编程中,调试通常是相当直接的。你可以阅读堆栈跟踪,查看问题的根源。完全是代码出现了故障?该故障是否发生在其它库的代码中?如果是这样,代码的哪一部分是调用了库,可能是传入了不正确的参数,从而导致故障?
7.1. 典型的响应式堆栈追踪
当你转向异步代码时,事情会变得更加复杂。
考虑一下下面的堆栈信息:
java.lang.IndexOutOfBoundsException: Source emitted more than one item
	at reactor.core.publisher.MonoSingle$SingleSubscriber.onNext(MonoSingle.java:129)
	at reactor.core.publisher.FluxFlatMap$FlatMapMain.tryEmitScalar(FluxFlatMap.java:445)
	at reactor.core.publisher.FluxFlatMap$FlatMapMain.onNext(FluxFlatMap.java:379)
	at reactor.core.publisher.FluxMapFuseable$MapFuseableSubscriber.onNext(FluxMapFuseable.java:121)
	at reactor.core.publisher.FluxRange$RangeSubscription.slowPath(FluxRange.java:154)
	at reactor.core.publisher.FluxRange$RangeSubscription.request(FluxRange.java:109)
	at reactor.core.publisher.FluxMapFuseable$MapFuseableSubscriber.request(FluxMapFuseable.java:162)
	at reactor.core.publisher.FluxFlatMap$FlatMapMain.onSubscribe(FluxFlatMap.java:332)
	at reactor.core.publisher.FluxMapFuseable$MapFuseableSubscriber.onSubscribe(FluxMapFuseable.java:90)
	at reactor.core.publisher.FluxRange.subscribe(FluxRange.java:68)
	at reactor.core.publisher.FluxMapFuseable.subscribe(FluxMapFuseable.java:63)
	at reactor.core.publisher.FluxFlatMap.subscribe(FluxFlatMap.java:97)
	at reactor.core.publisher.MonoSingle.subscribe(MonoSingle.java:58)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3096)
	at reactor.core.publisher.Mono.subscribeWith(Mono.java:3204)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3090)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3057)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3029)
	at reactor.guide.GuideTests.debuggingCommonStacktrace(GuideTests.java:995)
这里面有很多事情。我们得到一个 IndexOutOfBoundsException 异常,这告诉我们 源发射了超过一个以上的元素。
从下一行提到的 MonoSingle,我们可能很快就能推断出该源为一个Flux或者Mono。因此,这似乎是从一个 single 操作符报的错误。
参照 Mono#single 操作符的Javadoc,我们可以看到 single 有一个约定:源必须精确地发射一个元素。看来我们有一个源发射了超过一个以上的元素,因此违反了这一约定。
我们可以更深入地挖掘并确定那个源?下面这几行,对我们的帮助不大。它们通过多次调用 subscribe 和 request, 带我们了解了似乎是一个响应式链的内部。
通过略读这些行,我们至少可以开始形成一个出错的链的脑图:它似乎涉及到 MonoSingle 和 FluxFlatMap,FluxRange(每个在堆栈跟踪中都能获得几行,但总体上这三个类都涉及到了)。所以也许是一个 range().flatMap().single() 链?
但是如果我们在应用中大量使用该模式?这仍然不能说明什么问题,单纯的搜索 single 并不能发现问题。然后,最后一行值的是我们自己的一些代码。最终,我们离真相越来越近的。
不过,等一下。当我们跳到源文件时,我们只看到一个预先存在到 Flux 被订阅,如下所示:
toDebug.subscribe(System.out::println, Throwable::printStackTrace);所有这些都是在订阅时发生的,但是 Flux 本身并没有在那里声明。更糟糕的是,当我们转到声明变量的地方时时,我们会看到下面的内容:
public Mono<String> toDebug; //请忽略公共类属性变量没有在它被声明的地方被实例化。我们必须假设一个最坏的情况,即我们发现可能有几个不同的代码路径在应用程序中设置它。我们仍然不确定是哪一个引起的问题。
| 这有点类似于Reactor的运行时错误,而不是编译错误。 |
我们想更容易发现的是操作符添加到链的位置,即 Flux 声明的地方。我们通常将其称为 Flux 的 “装配”。
7.2. 激活调试模式 - 又名回溯
本节描述了最简单但也是最慢的方式来启用调试能力,因为它捕获每个操作符上的堆栈。了解更详细的调试方式,请看checkpoint() 替代方案,以及对于更高级性能的全局选项,请看可生产的全局调试。
|
尽管对于稍微有点经验的来说,堆栈跟踪能为还是能够表达一些信息,但是我们可以看出,在更高级的案例中,单凭它本身的效果并不理想。
幸运的是,Reactor自带了专门用于调试设计的装配时设施。
这可以通过在应用启动时(或至少在所怀疑的 Flux 或者 Mono 实例化前)自定义 Hooks.onOperator 钩子来实现,如下:
Hooks.onOperatorDebug();通过在这里包装操作符的构造和捕获堆栈跟踪开始对 Flux(和 Mono)操作符方法(装配到链的)的调用进行检测。因为这是在声明操作符链时完成的,所以钩子应该在这之前被激活,所以最安全的方式是直接在应用开始时就激活它。
之后,如果发生异常,失败的操作符能够引用该捕获的信息并将其附加到堆栈跟踪中。我们将捕获的装配信息称为 回溯。
在下一节中,我们将看到堆栈跟踪有什么不同,以及如何解释这些新的信息。
7.3. 在调试模式下读取堆栈跟踪
当我们再次使用最开始的例子,但在激活 operatorStacktrace 调试功能的时候,堆栈追踪如下:
java.lang.IndexOutOfBoundsException: Source emitted more than one item
	at reactor.core.publisher.MonoSingle$SingleSubscriber.onNext(MonoSingle.java:129)
	at reactor.core.publisher.FluxOnAssembly$OnAssemblySubscriber.onNext(FluxOnAssembly.java:375) (1)
...
(2)
...
	at reactor.core.publisher.Mono.subscribeWith(Mono.java:3204)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3090)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3057)
	at reactor.core.publisher.Mono.subscribe(Mono.java:3029)
	at reactor.guide.GuideTests.debuggingActivated(GuideTests.java:1000)
	Suppressed: reactor.core.publisher.FluxOnAssembly$OnAssemblyException: (3)
Assembly trace from producer [reactor.core.publisher.MonoSingle] : (4)
	reactor.core.publisher.Flux.single(Flux.java:6676)
	reactor.guide.GuideTests.scatterAndGather(GuideTests.java:949)
	reactor.guide.GuideTests.populateDebug(GuideTests.java:962)
	org.junit.rules.TestWatcher$1.evaluate(TestWatcher.java:55)
	org.junit.rules.RunRules.evaluate(RunRules.java:20)
Error has been observed by the following operator(s): (5)
|_ Flux.single ⇢ reactor.guide.GuideTests.scatterAndGather(GuideTests.java:949) (6)| 1 | 这是新的异常信息:我们可以看到捕获堆栈的包装操作符。 |
| 2 | 除此之外,第一部分的堆栈依然几乎相同,显示了一些操作符(所以我们在这里去掉了一些代码片段)内部。 |
| 3 | 这就是回溯开始出现的地方。 |
| 4 | 首先,我们得到一些装配操作符处的详细信息。 |
| 5 | 当错误通过操作符链传播时,我们还可以从头到尾(错误端到订阅端)追溯到该错误。 |
| 6 | 每个看到错误的操作符都会提到使用的用户类和行。 |
捕获的堆栈跟踪会作为简约的 OnAssemblyException 异常附加到原始错误中。它分为两部分,但第一部分是最有趣的。它显示了触发异常的操作符的构造路径。在这里,它显示了是 scatterAndGather 方法中创建的 single 导致了问题,它本身是通过JUnit执行的 populateDebug 方法调用的。
现在我们已经掌握了足够的信息来找到罪魁祸首,我们对 scatterAndGather 方法进行有意义的研究:
private Mono<String> scatterAndGather(Flux<String> urls) {
    return urls.flatMap(url -> doRequest(url))
           .single(); (1)
}| 1 | 果然,这里是 single 方法。 |
现在我们可以看到导致错误的根本原因是 flatMap 对几个url执行了几个HTTP调用,但是这个调用是用 single 串联起来的,限制性太强了。经过简短的使用 git blame,并与该行代码的作者进行了简短的讨论后,我们发现他打算使用限制性较小的 take(1) 来代替。
我们的问题已经解决了。
现在看下在堆栈跟踪中的这一行:
Error has been observed by the following operator(s):在这个特殊的例子中,调试堆栈跟踪的第二部分并不一定有意思,因为错误实际上发生在链中的最后一个操作符(最接近 订阅 的那个)。考虑另一个例子可能会更清晰:
FakeRepository.findAllUserByName(Flux.just("pedro", "simon", "stephane"))
              .transform(FakeUtils1.applyFilters)
              .transform(FakeUtils2.enrichUser)
              .blockLast();
现在想象一下,在 findAllUserByName 中,有一个 map 失败了。在这里,我们将看到下面的的回溯:
Error has been observed by the following operator(s):
	|_	Flux.map ⇢ reactor.guide.FakeRepository.findAllUserByName(FakeRepository.java:27)
	|_	Flux.map ⇢ reactor.guide.FakeRepository.findAllUserByName(FakeRepository.java:28)
	|_	Flux.filter ⇢ reactor.guide.FakeUtils1.lambda$static$1(FakeUtils1.java:29)
	|_	Flux.transform ⇢ reactor.guide.GuideDebuggingExtraTests.debuggingActivatedWithDeepTraceback(GuideDebuggingExtraTests.java:40)
	|_	Flux.elapsed ⇢ reactor.guide.FakeUtils2.lambda$static$0(FakeUtils2.java:30)
	|_	Flux.transform ⇢ reactor.guide.GuideDebuggingExtraTests.debuggingActivatedWithDeepTraceback(GuideDebuggingExtraTests.java:41)
这对应的是操作符链中被通知错误的那部分:
-
异常源于第一个
map。 -
它被第二个
map看到了(实际上这两个方法都对应于findAllUserByName方法)。 -
然后通过一个
filter和transform看到它,这表示链的那部分是由可重用的转换函数构成(这里是applyFilters工具方法)的。 -
最后,通过一个
elapsed和transform看到它。elapsed是由第二个转换的转换函数所使用。
当回溯作为简短的异常被附加到原始错误中,这可能在某种程度上会干扰另一种使用此机制的另一种异常:复合异常。这类异常可以直接通过 Exceptions.multiple(Throwable…) 来创建,或者通过一些可能连接多个错误源(如 Flux#flatMapDelayError)的操作符来创建。它们可以通过 Exceptions.unwrapMultiple(Throwable) 展开到 List 中,在这种情况下,回溯会被视为组合的一个组件,并成为返回的 List 的一部分。相反,如果不需要的话,可以通过 Exceptions.isTraceback(Throwable) 检查来标识回溯,并使用 Exceptions.unwrapMultipleExcludingTracebacks(Throwable) 将其排除在展开之外。
|
我们在这里以检测的形式处理,而创建堆栈追踪的代价是非常高的。这就是为什么这个调试功能只应该以可把控的方式激活,并只能当作最后的办法。
7.3.1. checkpoint() 替代方案
调试模式是全局的,它影响到应用程序中的每一个操作符,并将其组装到 Flux 或 Mono 中。这样做的好处是允许事后调试:无论是什么错误,我们都可以获取更多的信息来调试。
正如我们前面看到的,这种全局的能力是以牺牲性能(由于填充的堆栈跟踪的数量)为代价的。如果我们知道可能是某个操作符有问题,那么这个代价可以降低。但是,我们通常不知道哪个操作符出现了问题,除非我们明显地看到错误,看到自己丢失了组装信息,然后修改代码激活组装追踪,希望再次观察到相同的错误。
在那种场景下,我们必须切换到调试模式,并做好准备以便更好地观察到第二次出现的错误,这一次捕获到所有额外的信息。
如果你能识别出你在应用中组装的,且对其可用性至关重要的响应式链。那么你可以使用 checkpoint() 操作符将两种技术结合。
你可以将此操作符链接到方法链中。checkpoint 操作符的工作原理与像钩子版本一样,但仅适用于特定链的链接。
这里还有 checkpoint(String) 的另一种形式,能让你添加唯一的 String 标识符到组合的回溯。这样,就省略了堆栈追踪,并依靠描述来识别装配的位置。checkpoint(String) 较于普通的 checkpoint 代价要低。
checkpoint(String) 在其输出中(这搜索时会非常方便)包含了 “light” ,如下面例子所示:
...
	Suppressed: reactor.core.publisher.FluxOnAssembly$OnAssemblyException:
Assembly site of producer [reactor.core.publisher.ParallelSource] is identified by light checkpoint [light checkpoint identifier].
最后但并非最不重要的,如果你想要添加更通用的描述到检测点,但仍然依靠堆栈跟踪机制来识别装配的位置,你可以通过使用 checkpoint("description", true) 来强制执行该行为。我们现在又回到了回溯的初始信息,并添加了 description,如下例所示:
Assembly trace from producer [reactor.core.publisher.ParallelSource], described as [descriptionCorrelation1234] : (1)
	reactor.core.publisher.ParallelFlux.checkpoint(ParallelFlux.java:215)
	reactor.core.publisher.FluxOnAssemblyTest.parallelFluxCheckpointDescriptionAndForceStack(FluxOnAssemblyTest.java:225)
Error has been observed by the following operator(s):
|_ ParallelFlux.checkpoint ⇢ reactor.core.publisher.FluxOnAssemblyTest.parallelFluxCheckpointDescriptionAndForceStack(FluxOnAssemblyTest.java:225)| 1 | descriptionCorrelation1234 是 checkpont 中提供的描述。 |
该描述可以是一个静态的标识符或用户可读的描述,也可以是更广泛的相关ID(例如,在HTTP请求的情况下,来自于一个请求头的)。
当全局调试和本地 checkpoint() 都启用时,检测点的快照堆栈作为简短的错误输出附加到观察操作符图之后,并遵循相同的声明性顺序。
|
7.4. 可生产的全局调试
Reactor工程自带了一个独立的Java代理,可以增强你的代码并添加调试信息,而不需要花费捕获每个操作符调用的堆栈追踪的代价。其行为类似于激活调试模式 - 又名回溯,但是没有运行时的性能开销。
要在你的应用程序使用它,必须将其添加为依赖型。
下面的例子显示了如何在Maven中添加 reactor-tools 依赖项:
<dependencies><dependency>
<groupId>io.projectreactor</groupId>
<artifactId>reactor-tools</artifactId>
(1)
</dependency>| 1 | 如果你使用了BOM,你不需要指定 <version>。 |
下面的例子显示了如何在Gradle中添加 reactor-tools 依赖型:
dependencies 块dependencies {
compile 'io.projectreactor:reactor-tools'
}当然需要显式地初始化它:
ReactorDebugAgent.init();| 由于该工具会在加载的时候会增强你的类,所以最好把它放在main(String[])方法中的所有其它功能之前: |
public static void main(String[] args) {
    ReactorDebugAgent.init();
    SpringApplication.run(Application.class, args);
}
如果你不能及早地(例如在测试中)运行初始化,你也可以对现有的类进行重新处理:
ReactorDebugAgent.init();
ReactorDebugAgent.processExistingClasses();| 请注意,由于需要迭代所有加载的类并应用转换,重新处理需要花费几秒的时间。仅在一些调用位置没有增强时使用它。 |
7.4.1. 局限性
ReactorDebugAgent 作为一个Java代理实现,并使用 ByteBuddy 执行自我附加。自我附加可能不适用某些JVM,请参考ByteBuddy的文档获取更多详细信息。
7.4.2. 作为Java代理运行ReactorDebugAgent
如果你的环境不支持ByteBuddy的自我附加,你可以将 reactor-tools 作为Java代理运行:
java -javaagent reactor-tools.jar -jar app.jar7.4.3. 在构建时运行ReactorDebugAgent
也可以在构建时运行 reactor-tools,要做到这一点,你需要将其作为ByteBuddy的构建工具的插件来使用。
| 该转换将只应用于你的项目的类,类路径下的库并不会被增强。 |
<dependencies>
	<dependency>
		<groupId>io.projectreactor</groupId>
		<artifactId>reactor-tools</artifactId>
		(1)
		<classifier>original</classifier> (2)
		<scope>runtime</scope>
	</dependency>
</dependencies>

<build>
	<plugins>
		<plugin>
			<groupId>net.bytebuddy</groupId>
			<artifactId>byte-buddy-maven-plugin</artifactId>
			<configuration>
				<transformations>
					<transformation>
						<plugin>reactor.tools.agent.ReactorDebugByteBuddyPlugin</plugin>
					</transformation>
				</transformations>
			</configuration>
		</plugin>
	</plugins>
</build>| 1 | 如果你使用了BOM,你不需要指定 <version>。 |
| 2 | 这里的 classifier 很重要。 |
plugins {
	id 'net.bytebuddy.byte-buddy-gradle-plugin' version '1.10.9'
}

configurations {
	byteBuddyPlugin
}

dependencies {
	byteBuddyPlugin(
			group: 'io.projectreactor',
			name: 'reactor-tools',
			(1)
			classifier: 'original', (2)
	)
}

byteBuddy {
	transformation {
		plugin = "reactor.tools.agent.ReactorDebugByteBuddyPlugin"
		classPath = configurations.byteBuddyPlugin
	}
}| 1 | 如果你使用了BOM,你不需要指定 <version>。 |
| 2 | 这里的 classifier 很重要。 |
7.5. 记录序列
除了堆栈追踪调试和分析之外,在工具包中有另外一个强大的工具是在异步序列中追踪和记录事件的能力。
log() 操作符可以做到这一点。链接在序列中,能窥视它上游的每个 Flux 或 Mono 事件(包括 onNext,onError 和 `onComplete`以及订阅,取消和请求)。
例如,假设我们已经配置且激活了Logback,并配置了一条像 range(1,10).take(3) 这样的链。通过在 take 之前放置一个 log,我们可以深入了解其工作原理,以及它向上游传播什么样的事件,如下例所示:
Flux<Integer> flux = Flux.range(1, 10)
                         .log()
                         .take(3);
flux.subscribe();
这将打印出以下内容(通过日志记录的控制台附加器):
10:45:20.200 [main] INFO  reactor.Flux.Range.1 - | onSubscribe([Synchronous Fuseable] FluxRange.RangeSubscription) (1)
10:45:20.205 [main] INFO  reactor.Flux.Range.1 - | request(unbounded) (2)
10:45:20.205 [main] INFO  reactor.Flux.Range.1 - | onNext(1) (3)
10:45:20.205 [main] INFO  reactor.Flux.Range.1 - | onNext(2)
10:45:20.205 [main] INFO  reactor.Flux.Range.1 - | onNext(3)
10:45:20.205 [main] INFO reactor.Flux.Range.1 - | cancel() (4)在这里,除了记录器自己的格式(时间,线程,级别,消息),log() 操作符还可以用其自己的格式输出一些内容:
| 1 | 如果你使用的操作符在链中多次出现,reactor.Flux.Range.1 是日志的自动分类。它可以让你区分哪个操作符的事件被记录(在这种情况下,是 range)。你可以通过 log(String) 方法签名使用自定义类别覆盖标识符,在几个分开的字符后,实际的事件被打印出来。这里,我们得到一次 onSubscribe 调用,一次 request 调用, 三次 onNext 和一次 cancel 调用。对于第一行, 在`onSubscribe` 中,我们得到了 Subscriber 的实现,通常是对应于操作符的具体实现。在方括号之间,我们得到额外的信息,包括操作符是否可以通过同步或异步结合进行自动优化。 |
| 2 | 在第二行,我们可以看到,一个从下游向上传播的无界的请求。 |
| 3 | 然后range连续发送三个值。 |
| 4 | 在最后一行,我们看到 cancel()。 |
最后一行(4)是最有意思的。我们可以看到这里的 take 的作用。在看到足够多的元素发射后,将序列剪短。总而言之,一旦发射了用户请求的数量后,take() 就会导致源 cancel()。
Suggest Edit to "调试Reactor"
8. 暴露Reactor的指标
Reactor项目是一个旨在提高性能和更好地利用资源的库。但是要真正了解一个系统的性能,最好是能够监视其各种组件。
这也是为什么Reactor提供了一个内置的 Micrometer 集成的原因。
| 如果Micrometer不在类路径上,指标将是不可操作的。 |
8.1. 调度器指标
Reactor中的每个异步操作都是通过线程和调度器中描述的调度器抽象来完成的。这就是为什么监控你的调度器是很重要的,注意关键指标开始出现可疑的情况并作出相应反应。
要启用调度器指标,你需要使用以下方法:
Schedulers.enableMetrics();| 在调度器创建时执行检测。建议尽早调用该方法。 |
如果你使用的是Spring Boot,那么最好将调用放在 SpringApplication.run(Application.class, args) 调用之前。
|
一旦调度器指标被启用,并且只要它在类路径上,Reactor将使用Micrometer的支持来检测背后的大多数调度器的执行器。
关于暴露的指标,请参考 Micrometer的文档,如:
-
executor_active_threads
-
executor_completed_tasks_total
-
executor_pool_size_threads
-
executor_queued_tasks
-
executor_secounds_{count, max, sum}
由于一个调度器可能有多个执行器,每个执行器指标都有一个 reactor_scheduler_id 标签。
| Grafana + Prometheus用户可以使用 预建仪表板,其中包含线程,已完成任务,任务队列和其它有用的指标。 |
8.2. 生产者指标
有时,在响应式管道的某个阶段能够记录指标是非常有用的。
一种方法是将值手动推送到你选择的指标后端。另一种选择是使用Reactor内置的 Flux/Mono 的指标集成,并解析它们。
考虑下面的管道:
listenToEvents()
    .doOnNext(event -> log.info("Received {}", event))
    .delayUntil(this::processEvent)
    .retry()
    .subscribe();
为了启用这个 Flux(从 listenToEvents() 返回的) 的指标,我们需要为其命名并启用指标收集:
listenToEvents()
    .name("events") (1)
    .metrics() (2)
    .doOnNext(event -> log.info("Received {}", event))
    .delayUntil(this::processEvent)
    .retry()
.subscribe();| 1 | 在这一阶段,每个指标都将会被确定为 “事件”。 |
| 2 | Flux#metrics 操作符启用指标报告并使用管道中的最后一个的名称。 |
只需要加上这两个操作符,就会暴露出一大堆有用的指标!
| 指标名 | 类型 | 描述 |
|---|---|---|
reactor.subscribed |
计数 |
统计订阅了多少响应式序列 |
reactor.malformed.source |
计数 |
统计从异常的源(即onComplete之后的onNext)接收到的事件 |
reactor.requested |
分发概括 |
统计所有订阅者对命名Flux的请求量,直到至少有一个无界数量的请求为止 |
reactor.onNext.delay |
计时器 |
计量onNext信号之间的延迟 |
reactor.flow.duration |
计时器 |
从订阅到序列终止或取消之间的持续时间。添加状态标签以指定什么事件导致计时器结束( |
想知道你的事件处理由于某些错误而重启了多少次?请阅读 reactor.subscribed,因为 retry() 操作符在发生错误时会重新订阅生产者源。
对 “每秒的事件数” 指标感兴趣?测量 reactor.onNext.delay 的计数的速率。
想在监听器抛出错误时得到告警?带 status=error 标签的 reactor.flow.duration 是你的朋友。
8.2.2. 自定义标签
允许用户添加自定义标签到其响应式链:
listenToEvents()
    .tag("source", "kafka") (1)
    .name("events")
    .metrics() (2)
    .doOnNext(event -> log.info("Received {}", event))
    .delayUntil(this::processEvent)
    .retry()
.subscribe();| 1 | 设置一个自定义标签“source”为“kafka”。 |
| 2 | 除了上述常见的标签外,所有报告的指标都会有 source=kafka 标签。 |
Suggest Edit to "暴露Reactor的指标"
9. 高级特性和概念
本章涵盖了Reactor的高级特性和概念,包括以下内容:
9.1. 互用操作符用法
从简洁的代码角度来看,代码复用通常是一件好事。Reactor提供了一些可以帮助你重用和互用代码的方式,特别是对于你可能想在代码库中经常应用的操作符或操作符的组合。如果你想将操作符链作为配方,你可以创建一个操作符 “食谱” 的配方。
9.1.1. 使用 transform 操作符
transform 操作符可以让你将操作符链的一部分封装成一个函数。这个函数在组装时被应用到原始操作链上,使用封装的操作符来进行增强。这样做会将相同的操作应用于序列的所有订阅者,基本上相当于直接链接操作符。下面的代码显示了一个例子:
Function<Flux<String>, Flux<String>> filterAndMap =
f -> f.filter(color -> !color.equals("orange"))
      .map(String::toUpperCase);

Flux.fromIterable(Arrays.asList("blue", "green", "orange", "purple"))
	.doOnNext(System.out::println)
	.transform(filterAndMap)
	.subscribe(d -> System.out.println("Subscriber to Transformed MapAndFilter: "+d));
下图显示了 transform 操作符如何封装流:
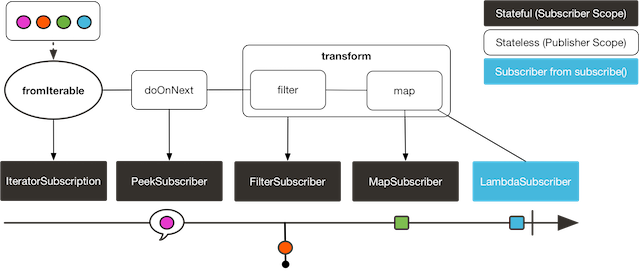
前面的例子产生以下输出:
blue
Subscriber to Transformed MapAndFilter: BLUE
green
Subscriber to Transformed MapAndFilter: GREEN
orange
purple
Subscriber to Transformed MapAndFilter: PURPLE
9.1.2. 使用 transformDeferred 操作符
transformDeferred 操作符类似于 transform,也可以让你将操作符封装在一个函数中。主要区别在于,此函数是 基于每个订阅者 应用于原始序列。这意味着这个函数实际上可以为每个订阅者(通过维护某种状态)产生不同的操作符链。下面的代码显示了一个例子:
AtomicInteger ai = new AtomicInteger();
Function<Flux<String>, Flux<String>> filterAndMap = f -> {
	if (ai.incrementAndGet() == 1) {
return f.filter(color -> !color.equals("orange"))
        .map(String::toUpperCase);
	}
	return f.filter(color -> !color.equals("purple"))
	        .map(String::toUpperCase);
};

Flux<String> composedFlux =
Flux.fromIterable(Arrays.asList("blue", "green", "orange", "purple"))
    .doOnNext(System.out::println)
    .transformDeferred(filterAndMap);

composedFlux.subscribe(d -> System.out.println("Subscriber 1 to Composed MapAndFilter :"+d));
composedFlux.subscribe(d -> System.out.println("Subscriber 2 to Composed MapAndFilter: "+d));
下图显示了 transformDeferred 操作符如何处理每个订阅者的转换:
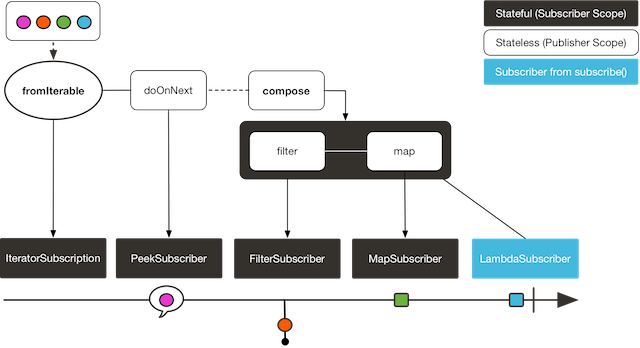
上面的例子产生以下输出:
blue
Subscriber 1 to Composed MapAndFilter :BLUE
green
Subscriber 1 to Composed MapAndFilter :GREEN
orange
purple
Subscriber 1 to Composed MapAndFilter :PURPLE
blue
Subscriber 2 to Composed MapAndFilter: BLUE
green
Subscriber 2 to Composed MapAndFilter: GREEN
orange
Subscriber 2 to Composed MapAndFilter: ORANGE
purple
9.2. 热与冷
到目前为止,我们已经认为所有的 Flux(和 Mono)都是一样的:它们都表示一个异步的数据序列,在订阅之前没有任何事情发生。
但实际上,生产者有两大派系:热与冷。
前面的描述适用于冷的这类生产者。它们会为每个订阅重新生成数据。如果没有创建订阅,数据永远不会被生成。
考虑一个HTTP请求:每个新的订阅者触发一次HTTP调用,但是如果没有人对结果感兴趣,就不进行调用。
另一方面,热的生产者不依赖于任何数量的订阅者。它们可能会立即开始发布数据,并在每当有一个新的 Subscriber 出现时(在这种情况下,当它订阅 后,订阅者只能看到发出的新的元素)继续这样做。对于热的生产者来说,在订阅前确实会发生 一些事情。
Reactor中为数不多的热操作符的一个例子就是 just:在组装时直接获取值,然后向订阅它的任何人重新发出。再次类比于HTTP的调用,如果获取的数据是一次HTTP调用的结果,那么只有一次网络调用,即初始化 just 时。
要将 just 转换成一个冷的生产者,你可以使用 defer。在我们的示例中,它将HTTP请求推迟到订阅的时候(并会导致对于每个新的订阅者有单独的网络调用)。
Reactor中的绝大多数热生产者扩展了 Processor。
|
考虑另外两个例子。下面的代码显示的是第一个例子:
Flux<String> source = Flux.fromIterable(Arrays.asList("blue", "green", "orange", "purple"))
                          .map(String::toUpperCase);

source.subscribe(d -> System.out.println("Subscriber 1: "+d));
source.subscribe(d -> System.out.println("Subscriber 2: "+d));
第一个例子产生以下输出:
Subscriber 1: BLUE
Subscriber 1: GREEN
Subscriber 1: ORANGE
Subscriber 1: PURPLE
Subscriber 2: BLUE
Subscriber 2: GREEN
Subscriber 2: ORANGE
Subscriber 2: PURPLE
下图显示了重播行为:
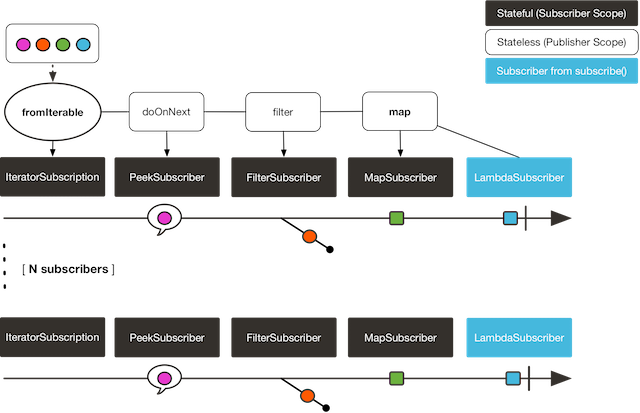
两个订阅者都能捕获所有的四种颜色,因为每个订阅者都会导致操作符在 Flux 上定义的过程运行。
将第一个例子和第二个例子进行比较,如下代码所示:
DirectProcessor<String> hotSource = DirectProcessor.create();

Flux<String> hotFlux = hotSource.map(String::toUpperCase);


hotFlux.subscribe(d -> System.out.println("Subscriber 1 to Hot Source: "+d));

hotSource.onNext("blue");
hotSource.onNext("green");

hotFlux.subscribe(d -> System.out.println("Subscriber 2 to Hot Source: "+d));

hotSource.onNext("orange");
hotSource.onNext("purple");
hotSource.onComplete();
第二个例子产生以下输出:
Subscriber 1 to Hot Source: BLUE
Subscriber 1 to Hot Source: GREEN
Subscriber 1 to Hot Source: ORANGE
Subscriber 2 to Hot Source: ORANGE
Subscriber 1 to Hot Source: PURPLE
Subscriber 2 to Hot Source: PURPLE
下图显示了订阅是如何广播的:
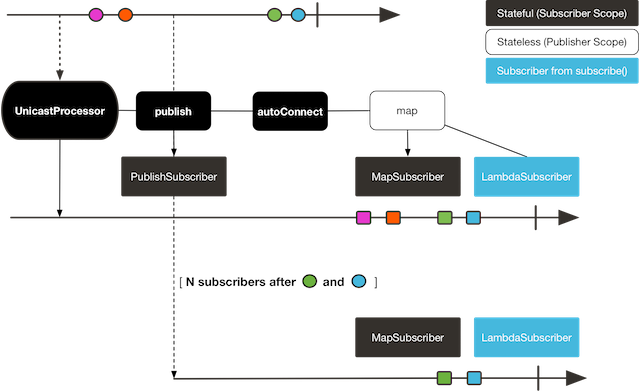
订阅者1捕获了所有四种颜色。在前面两种颜色产生后创建订阅者2,只捕获了后面两种颜色。这种差异导致了 ORANGE 和 PURPLE 的输出加倍。Flux上操作符所描述的过程,无论订阅何时被添加,都会运行。
9.3. 使用 ConnectableFlux 向多个订阅者广播
有时,你可能不想延迟,只是推迟某些处理到订阅者的订阅时候,而实际上是想让他们中的几个聚合,然后触发订阅和数据生成。
这就是 ConnectableFlux 的作用。Flux API 中包含了两个主要的模式,可以返回一个 ConnectableFlux:publish 和 replay。
-
publish尝试动态地维护各个订阅者的需求,在背压方面,通过转发这些请求给源。最值得注意的是,如果任何订阅者有一个挂起的请求0,publish将暂停向源的请求。 -
replay缓冲第一次订阅开始的数据,直到达到可配置的限制(在时间和缓冲区大小上)。它将重新发出数据给后续订阅者。
ConnectableFlux 提供了额外的方法来管理下游订阅与原始源的订阅。这些额外方法包括:
-
一旦对
Flux达到足够多的订阅,可以手动调用connect()。这样将触发对上游源的订阅。 -
一旦达到
n个订阅,autoConnect(n)可以自动做相同的事情。 -
refCount(n)不仅自动跟踪到来的订阅,而且还可以检测这些订阅何时被取消。如果跟踪的订阅者不足,则源将 ”disconnected“,如果稍后有额外的订阅者出现,则将导致对源产生新的订阅。 -
refCount(int, Duration)增加了一个 “宽限期”。一旦跟踪的订阅者数量太低,它会在断开源之前等待Duration持续时间,有可能让足够多的新的订阅者进入并再次超过连接阀值。
请看下面的例子:
Flux<Integer> source = Flux.range(1, 3)
                           .doOnSubscribe(s -> System.out.println("subscribed to source"));

ConnectableFlux<Integer> co = source.publish();

co.subscribe(System.out::println, e -> {}, () -> {});
co.subscribe(System.out::println, e -> {}, () -> {});

System.out.println("done subscribing");
Thread.sleep(500);
System.out.println("will now connect");

co.connect();
前面的代码产生以下输出:
done subscribing
will now connect
subscribed to source
1
1
2
2
3
3
下面的代码使用 autoConnect:
Flux<Integer> source = Flux.range(1, 3)
                           .doOnSubscribe(s -> System.out.println("subscribed to source"));

Flux<Integer> autoCo = source.publish().autoConnect(2);

autoCo.subscribe(System.out::println, e -> {}, () -> {});
System.out.println("subscribed first");
Thread.sleep(500);
System.out.println("subscribing second");
autoCo.subscribe(System.out::println, e -> {}, () -> {});
前面的代码产生下面的输出:
subscribed first
subscribing second
subscribed to source
1
1
2
2
3
3
9.4. 三种批处理
当你有很多的元素并且想把它们分批的时候,在Reactor中,你大致有三个解决方案:分组,窗口化和缓冲。这三者概念上接近,因为它们将一个 Flux<T> 重新分配到一个集合中。分组和窗口化会创建一个 Flux<Flux<T>>,而缓冲则将聚合到一个 Collection<T>。
9.4.1. 用 Flux<GroupedFlux<T>> 分组
分组是将源的 Flux<T> 分成多个批次的行为,每个批次匹配一个键。
相关的操作符是 groupBy。
每个组都表示为一个 GroupedFlux<T>,你可以通过调用其 key() 方法来得到键。
组的内容的连续性是没有必要的。一旦一个源的元素产生一个新的键,键的组就会被打开,并且与该键匹配的元素就会出现在该组中(几个组可以同时打开)。
这意味着组:
-
总是不相交的(一个源元素只属于一个组)。
-
可以包含原始序列中不同位置的元素。
-
永不为空。
下面的例子按值是偶数还是奇数进行分组:
StepVerifier.create(
	Flux.just(1, 3, 5, 2, 4, 6, 11, 12, 13)
		.groupBy(i -> i % 2 == 0 ? "even" : "odd")
		.concatMap(g -> g.defaultIfEmpty(-1) //如果是空的组,就显示出来
				.map(String::valueOf) //映射为字符
				.startWith(g.key())) //以组的键开始
	)
	.expectNext("odd", "1", "3", "5", "11", "13")
	.expectNext("even", "2", "4", "6", "12")
	.verifyComplete();
分组最适合具有中等到较低组数的情况。还必须强制性地使用组(例如,通过 flatMap),以便 groupBy 继续从上游获取数据并为更多的组提供数据。有时,这两个约束成倍增加并导致挂起,例如当基数较高且 flatMap 消费组的并发性太低时。
|
9.4.2. Flux<Flux<T>> 窗口化
窗口化是将源 Flux<T> 根据大小,时间,定义边界的谓词或边界定义的 Publisher 的标准, 将源 Flux<T> 拆分为 窗口 的操作。
相关的操作符是 window,windowTimeout,windowUntil,windowWhile 和 windowWhen。
与 groupBy 不同的是,后者是根据传入的键随机重叠,窗口(大多数时候)是按顺序打开的。
不过,有些形式依然是可以重叠的。例如,在 window(int maxSize, int skip) 中,maxSize 参数是窗口关闭后的元素数,而 skip 参数是当新的窗口开启后源中元素的数量。如果 maxSize > skip,则会在前一个窗口关闭前打开一个新的窗口,然后两个窗口重叠。
下面的例子显示的是重叠的窗口:
StepVerifier.create(
	Flux.range(1, 10)
		.window(5, 3) //重叠窗口
		.concatMap(g -> g.defaultIfEmpty(-1)) //空窗口显示为-1
	)
		.expectNext(1, 2, 3, 4, 5)
		.expectNext(4, 5, 6, 7, 8)
		.expectNext(7, 8, 9, 10)
		.expectNext(10)
		.verifyComplete();
使用相反的配置(maxSize < skip),某些源的元素被丢弃,不属于任何窗口。
|
在通过 windowUntil 和 windowWhile 进行基于谓词的窗口化的情况下,后续源的元素与谓词不匹配也可能会导致空窗口,如下例所示:
StepVerifier.create(
	Flux.just(1, 3, 5, 2, 4, 6, 11, 12, 13)
		.windowWhile(i -> i % 2 == 0)
		.concatMap(g -> g.defaultIfEmpty(-1))
	)
		.expectNext(-1, -1, -1) //分别触发奇数 1 3 5
		.expectNext(2, 4, 6) // 11 触发
		.expectNext(12) // 13 触发
		// 但是没有发出空的完成窗口(将包含额外的匹配元素)
		.verifyComplete();
9.4.3. 用 Flux<List<T>> 缓冲
缓冲类似于窗口化,但有以下的不同:与产生 窗口(每个都是一个 Flux<T>)相反,它产生 缓冲区(即 Collection<T>-- 默认情况下为 List<T>)。
用于缓冲的操作符与窗口化操作符相同:buffer,bufferTimeout,bufferUntil,bufferWhile,和 bufferWhen。
当相应的窗口化操作符打开一个窗口时,缓冲操作符创建一个新的集合并开始向其中添加元素。当窗口关闭时,缓冲操作符发出集合。
缓冲也可以导致源元素丢弃或具有重叠的缓冲区,如下例所示:
StepVerifier.create(
	Flux.range(1, 10)
		.buffer(5, 3) //重叠缓冲区
	)
		.expectNext(Arrays.asList(1, 2, 3, 4, 5))
		.expectNext(Arrays.asList(4, 5, 6, 7, 8))
		.expectNext(Arrays.asList(7, 8, 9, 10))
		.expectNext(Collections.singletonList(10))
.verifyComplete();与在窗口化中不同,bufferUntil 和 bufferWhile 不会发出空的缓冲区,如下例所示:
StepVerifier.create(
	Flux.just(1, 3, 5, 2, 4, 6, 11, 12, 13)
		.bufferWhile(i -> i % 2 == 0)
	)
	.expectNext(Arrays.asList(2, 4, 6)) // 11 触发
	.expectNext(Collections.singletonList(12)) // 13 触发
	.verifyComplete();
9.5. 用 ParallelFlux 并行化工作
如今,随着多核架构变得普遍,能够轻松实现并行化工作很重要。Reactor提供了一种特殊的 ParallelFlux,它暴露了为并行化而优化的操作符,从而帮助我们实现了这一点。
要获得一个 ParallelFlux,你可以在任何 Flux 上使用 parallel() 操作符。该方法本身并不会使工作并行化。而是将负载划分为 “轨道”(默认情况下,轨道的数量与CPU的核数相同)。
为了告诉生成的 ParallelFlux 在哪里运行每个轨道(并且,通过扩展,并行化地运行轨道),你必须使用 runOn(Scheduler)。注意有一个推荐的专用的 Scheduler 用于并行化工作:Schedulers.parallel()。
比较一下下面两个例子:
Flux.range(1, 10)
    .parallel(2) (1)
.subscribe(i -> System.out.println(Thread.currentThread().getName() + " -> " + i));| 1 | 我们强制使用多个轨道而不是依赖于CPU的核数。 |
Flux.range(1, 10)
    .parallel(2)
    .runOn(Schedulers.parallel())
    .subscribe(i -> System.out.println(Thread.currentThread().getName() + " -> " + i));
第一个例子产生以下输出:
main -> 1
main -> 2
main -> 3
main -> 4
main -> 5
main -> 6
main -> 7
main -> 8
main -> 9
main -> 10
第二个例子正确地并行化在两个线程上,如下面的输出所示:
parallel-1 -> 1
parallel-2 -> 2
parallel-1 -> 3
parallel-2 -> 4
parallel-1 -> 5
parallel-2 -> 6
parallel-1 -> 7
parallel-1 -> 9
parallel-2 -> 8
parallel-2 -> 10
如果你一旦并行处理你的序列,你想要恢复为 “正常” 的 Flux,并按顺序的方式应用其余的操作符链,则可以使用 ParallelFlux 上的 sequential() 方法。
注意,如果你用一个 Subscriber subscribe ParallelFlux,则会隐式的应用 sequential(),但当使用基于lambda形式的 subscribe 则不能。
还要注意的是, subscribe(Subscriber<T>) 合并了所有的轨道,而 subscribe(Consumer<T>) 运行所有的轨道。如果 subscribe() 方法具有lambda,则每个lambda执行的次数与轨道执行的次数相同。
你还可以通过 groups() 方法来访问各个轨道或 “groups” 作为一个 Flux<GroupedFlux<T>>,并通过 composeGroup() 方法对其应用其他的操作符。
9.6. 替换默认的 Schedulers
正如我们在线程和调度器一节中所描述的那样,Reactor核心自带了几个 Scheduler 实现。虽然你总是可以通过 new* 工厂方法创建新的实例,但每个 Scheduler 风格都有一个默认的单例实例,可直接通过工厂方法(例如 Schedulers.boundedElastic() 与 Schedulers.newBoundedElastic(…))访问。
这些默认的实例是操作符使用的,如果没有明确指定一个 Scheduler 时,需要一个 Scheduler 实例。例如,Flux#delayElements(Duration) 使用 Schedulers.parallel() 实例。
但是,在某些情况下,你可能需要以交叉的方式使用其他东西来更改这些默认实例,而不必确保你调用的每个操作符都有你指定的 Scheduler 作为参数。一个例子就是通过包装实际的调度器来测量每个调度任务花费的时间,以进行检测的目的。换句话说,你可能想要改变默认的 Schedulers。
可以通过 Schedulers.Factory 类来更改默认的调度器。默认情况下,Factory 通过类似的名称方法创建所有标准的 Scheduler。你可以用你的自定义实现覆盖这些方法。
此外,该工厂还暴露了另一种自定义方法:decorateExecutorService。它在 ScheduledExecutorService(即使是非默认实例,例如通过调用 Schedulers.newParallel() 创建的)所支持的每个响应式核心 Scheduler 创建过程中调用。
这允许你调整要使用的 ScheduledExecutorService:默认的是暴露为 Supplier,并根据所配置的 Scheduler 的类型,你可以选择完全绕过该supplier并返回你自己的实例,或可以通过 get() 得到默认实例并将其包装。
一旦你创建了满足你需要的 Factory,你必须通过调用 Schedulers.setFactory(Factory) 来对其进行设置。
|
最后,在 Schedulers 中还有最后一个可定制的钩子:onHandleError。每当提交到 Scheduler 的 Runnable 任务抛出 Exception(注意,如果为运行任务的 Thread 设置了 UncaughtExceptionHandler 处理器,则处理器和钩子都会被调用)时调用。
9.7. 使用全局钩子
Reactor还有另一类可配置的回调,Reactor操作符在各种情况下都会调用它们。它们都被设置在 Hooks 类中,分为三类:
9.7.1. 删除钩子
当源操作符不符合响应式流规范时,删除钩子将会被调用。这些错误超出了正常的执行路径(即,它们不能通过 onError 传播)。
通常,尽管之前已经调用了 onCompleted,Publisher 也会在操作符上调用 onNext。在这种情况下,onNext 的值将会被删除。对于无关的 onError 信号也是如此。
相应的钩子 onNextDropped 和 onErrorDropped,允许你对这些删除提供一个全局的 Consumer。例如,如果需要的话(因为不会到达响应式链的其他部分),你可以使用它来记录删除和清理与某个值相关的资源。
连续设置两次钩子是附加的:调用你提供的每个消费者。可以使用 Hooks.resetOn*Dropped() 方法将钩子完全重置为默认值。
9.7.2. 内部错误钩子
在执行 onNext,onError,和 onComplete 方法时抛出意外的 Exception 时,操作符将调用 onOperatorError 钩子。
与前一类不同,这仍然是在正常的执行路径内。一个典型的例子就是带有map函数的 map 操作符抛出 Exception(例如,除以零)。在这一点上,仍然可以通过平常的 onError 方式,这正是操作符需要做的。
首先,它通过 onOperatorError 传递 Exception。这个钩子可以让你检查错误(以及相关的导致错误的值)并更改 Exception。当然,你可以在一旁做一些事情,比如记录日志并返回原始的 Exception。
注意,你可以多次设置 onOperatorError 钩子。可以为特定的 BiFunction 提供一个 String 标识符,后续不同键的调用将这些函数连接起来,这些函数都会被执行。另一方面,重复使用同一个键两次可以让你替换之前设置过的函数。
因此,可以完全重置(通过使用 Hooks.resetOnOperatorError())钩子的默认行为或只对指定的 key 进行部分重置(通过使用 Hooks.resetOnOperatorError(String))。
9.7.3. 组装钩子
这些钩子和操作符的生命周期紧密相连。当一个操作符链组装(即实例化)时被调用。onEachOperator 通过返回不同的 Publisher 允许你动态改变组装在链中的每个操作符。onLastOperator 也是类似的,除了仅在链的最后一个操作符即 subscribe 调用之前被调用。
如果你想要用横切 Subscriber 实现来装饰所有的操作符,你可以研究一下 Operators#lift* 方法,以帮助你处理各种类型的Reactor的 Publishers(Flux,Mono,ParallelFlux,GroupedFlux 和 ConnectableFlux),以及它们的 Fuseable 版本。
像 onOperatorError 一样,这些钩子是累积的,可以用一个键来标识。它们也可以被部分或全部重置。
9.7.4. 预设钩子
Hooks 工具类提供了两个预设的钩子。你可以通过调用相应的方法来选择性的替换默认行为,而不是自己定义钩子:
-
onNextDroppedFail():onNextDropped用于抛出一个Exceptions.failWithCancel()异常。它现在默认记录在调试级别删除的值。要回到以前的默认抛出行为,使用onNextDroppedFail()。 -
onOperatorDebug():此方法会激活 调试模式。它与onOperatorError钩子紧密相连,因此调用resetOnOperatorError()也能重置它。因为它在内部使用了一个特定的键,你也可以通过使用resetOnOperatorDebug()单独重置它。
9.8. 为响应式序列添加上下文
从命令式编程观点转换到响应式编程思维遇到的重大技术挑战之一在于如何应对线程化。
与你可能习惯的命令式编程相反,在响应式编程中,你可以使用 Thread 处理几个大致同时(实际上,在非阻塞的锁步)运行的异步序列。执行也可以很容易且经常从一个线程跳到另一个线程。
这种约定对于使用依赖于线程模型使得更 “稳定” 的特性的开发者相当困难,例如 ThreadLocal。因为它可以让你把数据与线程关联起来,但在响应式上下文中使用它就变得很棘手。因此,依赖于 ThreadLocal 的库与Reactor一起使用时,至少带来了新的挑战。最糟糕的是,它们不能工作或者甚至失败。使用Logback的MDC来存储并记录日志相关性ID就是这种情况的一个典型例子。
使用 ThreadLocal 的通常解决方法是通过使用(例如) Tuple2<T, C> 按顺序将上下文的数据 C 沿业务数据 T 移动。这确实看起来不好,并且将正交关系(上下文数据)泄露到方法和 Flux 签名中。
从 3.1.0 版本开始,Reactor自带了类似于 ThreadLocal 的一个高级功能,但可以应用于 Flux 或 Mono 而不是 Thread。这个特性称为 Context。
为了说明它是什么样子的,下面的例子同时从 Context 写入和获取:
String key = "message";
Mono<String> r = Mono.just("Hello")
                .flatMap( s -> Mono.subscriberContext()
                                   .map( ctx -> s + " " + ctx.get(key)))
                .subscriberContext(ctx -> ctx.put(key, "World"));

StepVerifier.create(r)
            .expectNext("Hello World")
            .verifyComplete();
在下面的章节中,我们将介绍 Context 以及如何使用它,以便你最终能够理解前面的例子。
这是一个更适合库开发人员的高级功能。它需要充分理解 Subscription 的生命周期,并且用于负责订阅的库。
|
9.8.1. Context API
Context 是一个类似于 Map 的接口。它存储键值对,并允许你根据键获取你存储的值。更具体地说:
-
键和值都属于
Object类型,因此一个Context实例可以包含来源于不同库和源的任意数量且有巨大差异的值。 -
Context是不可更改的。 -
使用
put(Object key, Object value)存储一个键值对,返回一个新的Context实例。你可以通过使用putAll(Context)将两个上下文合并到一个新的上下文中。 -
你可以通过
hasKey(Object key)检查键是否存在。 -
使用
getOrDefault(Object key, T defaultValue)来获取值(强转为T)或如果Context实例没有该键则返回默认值。 -
使用
getOrEmpty(Object key)获得一个Optional<T>(Context实例尝试强转存储值为T)。 -
使用
delete(Object key)来删除与某个键相关联的值,返回一个新的Context。
|
当你创建一个 另外,你也可以通过使用 |
9.8.2. 将 Context 绑定到 Flux 并编写
为了使 Context 有用,它必须与一个特定的序列绑定,并且可以被链中的每个操作符访问。注意,操作符必须是Reactor的原生操作符,因为 Context 是Reactor所特有的。
实际上,Context 与链中的每个 Subscriber 所绑定。它使用 Subscription 传播机制使其在每个操作符上都可用,从最后的 subscribe 开始向上移动。
为了填充只能在订阅时完成的 Context,你需要使用 subscriberContext 操作符。
subscriberContext(Context) 合并你提供的 Context 和来自下游(记住,Context 是从链的底部向上传播的)的 Context。这是通过调用 putAll 完成的,从而产生一个新的上游 Context。
你也可以使用更高级的 subscriberContext(Function<Context, Context>)。它从下游接收 Context 的状态,它允许你根据需要增加或删除值,并返回新的 Context 来使用。你甚至可以决定返回一个完全不同的实例,尽管实际上不建议(这样做可能会影响到依赖于 Context 的第三方库)这样做。
|
9.8.3. 读取 Context
一旦你填充了一个 Context,你就可以检索数据。在大多数情况下,将信息放到 Context 的职责是在最终用户这边,而利用这些信息是第三方库中,因为这些库通常在客户端代码的上游。
从上下文中读取数据的工具是 Mono.subscriberContext() 静态方法。
9.8.4. 简单的 Context 示例
本节中的示例是为了更好地理解一些使用 Context 的注意事项。
首先,我们回顾一下我们引言中的简单示例,如下示例所示:
String key = "message";
Mono<String> r = Mono.just("Hello")
                .flatMap( s -> Mono.subscriberContext() (2)
                                   .map( ctx -> s + " " + ctx.get(key))) (3)
                .subscriberContext(ctx -> ctx.put(key, "World")); (1)

StepVerifier.create(r)
            .expectNext("Hello World") (4)
.verifyComplete();| 1 | 操作符链以 subscriberContext(Function) 调用结束,该调用以 "message" 为键,将 "World" 放到 Context 中。 |
| 2 | 我们对源元素进行 flatMap,用 Mono.subscriberContext() 具体化 Context。 |
| 3 | 然后,我们用 map 来提取与 "message" 相关联的数据,并将其与原来的值进行拼接。 |
| 4 | 由此产生对 Mono<String> 发出 "Hello World"。 |
上面的数字与实际的行顺序没有关系。它代表的是执行顺序。即使 subscriberContext 是链的最后一部分,它仍然是最先被执行(由于它订阅时间性质以及订阅信号从下至上流动的事实)的那个。
|
在你的操作符链中,写入 Context 和读取 Context 的相对位置是很重要的。Context 是不可变的,其内容只能被它上面的操作符看到,如下面的例子:
|
String key = "message";
Mono<String> r = Mono.just("Hello")
                     .subscriberContext(ctx -> ctx.put(key, "World")) (1)
                     .flatMap( s -> Mono.subscriberContext()
                                        .map( ctx -> s + " " + ctx.getOrDefault(key, "Stranger")));  (2)

StepVerifier.create(r)
            .expectNext("Hello Stranger") (3)
.verifyComplete();| 1 | 在链中写入 Context 的位置太在上面了。 |
| 2 | 因此,在 flatMap 中,这里没有我们键关联的值。而是使用了一个默认值。 |
| 3 | 由此产生的 Mono<String> 发出 "Hello Stranger"。 |
下面的例子还演示了 Context 的不可变特性,以及 Mono.subscriberContext() 如何始终返回由 subscriberContext 调用设置的 Context:
String key = "message";

Mono<String> r = Mono.subscriberContext() (1)
	.map( ctx -> ctx.put(key, "Hello")) (2)
	.flatMap( ctx -> Mono.subscriberContext()) (3)
	.map( ctx -> ctx.getOrDefault(key,"Default")); (4)

StepVerifier.create(r)
	.expectNext("Default") (5)
.verifyComplete();| 1 | 我们将 Context 具体化 |
| 2 | 在 map 中,我们试图将其转换 |
| 3 | 我们在 flatMap 中重新实现了 Context |
| 4 | 我们尝试在 Context 中读取键 |
| 5 | 键的值没有设为 "Hello" |
同样,在多次尝试将同一个键写入 Context 的情况下,写入的相对顺序也很重要。读取 Context 的操作符会看到最接近它们设置的值,如下例所示:
String key = "message";
Mono<String> r = Mono.just("Hello")
                .flatMap( s -> Mono.subscriberContext()
                                   .map( ctx -> s + " " + ctx.get(key)))
                .subscriberContext(ctx -> ctx.put(key, "Reactor")) (1)
                .subscriberContext(ctx -> ctx.put(key, "World")); (2)

StepVerifier.create(r)
            .expectNext("Hello Reactor") (3)
.verifyComplete();| 1 | 尝试写入键 "message"。 |
| 2 | 另一次尝试写入键 "message"。 |
| 3 | map 只看到了最接近它(在它下面)设置的值:"Reactor"。 |
在前面的例子中,Context 在订阅期间被填充了 "World"。然后订阅信号向上移动,另一个写操作发生了。这就产生了第二个不可变的 Context,其值为 "Reactor"。之后,数据开始流动。flatMap 看到离他最近的 Context,也就是我们的第二个 Context,其值为 "Reactor"。
你可能会想知道,Context 是否会随着数据信号一起传播。如果是那种情况下的话,再在这两个写操作之间放置另一个 flatMap,那么就会使用最上面的 Context。但事实并未如此,下面的例子就证明了这一点:
String key = "message";
Mono<String> r = Mono.just("Hello")
                     .flatMap( s -> Mono.subscriberContext()
                                        .map( ctx -> s + " " + ctx.get(key))) (3)
                     .subscriberContext(ctx -> ctx.put(key, "Reactor")) (2)
                     .flatMap( s -> Mono.subscriberContext()
                                        .map( ctx -> s + " " + ctx.get(key))) (4)
                     .subscriberContext(ctx -> ctx.put(key, "World")); (1)

StepVerifier.create(r)
            .expectNext("Hello Reactor World") (5)
.verifyComplete();| 1 | 第一次写操作。 |
| 2 | 第二次写操作。 |
| 3 | 第一个 flatMap 看到第二次写入的值。 |
| 4 | 第二个 flatMap 将第一次的结果与第一次写入的值连接起来。 |
| 5 | Mono 发出 "Hello Reactor World"。 |
原因是 Context 与 Subscriber 相关联,每个操作符通过下游的 Subscriber 来请求访问 Context。
最后一个有趣的传播情况是将 Context 也被写到 flatMap 中,如下例所示:
String key = "message";
Mono<String> r =
        Mono.just("Hello")
            .flatMap( s -> Mono.subscriberContext()
                               .map( ctx -> s + " " + ctx.get(key))
            )
            .flatMap( s -> Mono.subscriberContext()
                               .map( ctx -> s + " " + ctx.get(key))
                               .subscriberContext(ctx -> ctx.put(key, "Reactor")) (1)
            )
            .subscriberContext(ctx -> ctx.put(key, "World")); (2)

StepVerifier.create(r)
            .expectNext("Hello World Reactor")
.verifyComplete();| 1 | 这个 subscriberContext 不会影响到 flatMap 之外的任何东西。 |
| 2 | 这个 subscriberContext 会影响到主序列的 Context。 |
在前面的例子中,最终发出的值为 "Hello World Reactor" 而不是 "Hello Reactor World",因为写 "Reactor" 的 subscriberContext 是作为第二个 flatMap 的内部序列的一部分。因此,它不可见或通过主序列传播,且第一个 flatMap 也看不到它。传播和不可变性将创建中间内部序列的操作符(例如 flatMap)中的 Context 隔离。
9.8.5. 完整的例子
现在我们可以考虑一个更真实的例子,一个库从 Context 中读取信息:一个将 Mono<String> 作为 PUT 的数据源,但同时也会寻找一个特定的上下文键,以将相关的ID添加到请求头中的响应式HTTP客户端。
从用户的角度来看,调用如下:
doPut("www.example.com", Mono.just("Walter"))为了传播一个相关的ID,它将调用如下:
doPut("www.example.com", Mono.just("Walter"))
	.subscriberContext(Context.of(HTTP_CORRELATION_ID, "2-j3r9afaf92j-afkaf"))
正如前面的代码片段所示,用户代码使用 subscriberContext 填充具有 HTTP_CORRELATION_ID 键值对的 Context。操作符的上游是由HTTP客户端库返回的 Mono<Tuple2<Integer, String>>(HTTP响应的简单表示)。所以它有效地将信息从用户代码传递给框架代码。
下面的例子显示了从框架角度的模拟代码,读取上下文,找到相关ID并 “构造请求”。
static final String HTTP_CORRELATION_ID = "reactive.http.library.correlationId";

Mono<Tuple2<Integer, String>> doPut(String url, Mono<String> data) {
	Mono<Tuple2<String, Optional<Object>>> dataAndContext =
			data.zipWith(Mono.subscriberContext() (1)
			                 .map(c -> c.getOrEmpty(HTTP_CORRELATION_ID))); (2)

	return dataAndContext
			.<String>handle((dac, sink) -> {
				if (dac.getT2().isPresent()) { (3)
					sink.next("PUT <" + dac.getT1() + "> sent to " + url + " with header X-Correlation-ID = " + dac.getT2().get());
				}
				else {
					sink.next("PUT <" + dac.getT1() + "> sent to " + url);
				}
				sink.complete();
			})
			.map(msg -> Tuples.of(200, msg));
}| 1 | 通过 Mono.subscriberContext() 具体化 Context。 |
| 2 | 提取相关ID键的值,作为 Optional。 |
| 3 | 如果键存在于上下文中,则使用相关的ID作为头。 |
框架代码段用 Mono.subscriberContext() 压缩数据 Mono。为框架提供了 Tuple2<String, Context>,并且上下文中包含了来自下游(因为它位于直接订阅的路径)的 HTTP_CORRELATION_ID 条目。
然后,框架代码使用 map 提取该键的 Optional<String>,如果该条目存在,它将传递的相关ID作为 X-Correlation-ID 头。这最后一部分由 handle 模拟。
整个验证框架代码使用的相关ID的整个测试可以写成如下所示:
@Test
public void contextForLibraryReactivePut() {
	Mono<String> put = doPut("www.example.com", Mono.just("Walter"))
			.subscriberContext(Context.of(HTTP_CORRELATION_ID, "2-j3r9afaf92j-afkaf"))
			.filter(t -> t.getT1() < 300)
			.map(Tuple2::getT2);

	StepVerifier.create(put)
	            .expectNext("PUT <Walter> sent to www.example.com with header X-Correlation-ID = 2-j3r9afaf92j-afkaf")
	            .verifyComplete();
}
9.9. 处理需要清理的对象
在非常特殊的情况下,你的应用程序可能会处理那些一旦不再使用就需要某种形式清理的类型。这是一个高级的场景 — 例如,当有引用计数对象或处理堆外对象时。Netty的 ByteBuf 就是一个很好的例子。
为了确保对此类对象进行正确的清理,你需要基于 Flux-by-Flux 以及在几个全局钩子(参考 使用全局钩子)中对其进行说明:
-
doOnDiscardFlux/Mono操作符 -
onOperatorError钩子 -
onNextDropped钩子 -
操作符特定的处理器
这是必要的,因为每个钩子都考虑到了特定的清理子集,用户可能希望(例如)除了在 onOperatorError 中的清理逻辑之外,还需要实现特定的错误处理逻辑。
注意,有些操作符不太适合处理需要清理的对象。例如,bufferWhen 可以引入重叠的缓冲区,这意味着我们之前使用的已丢弃的 “本地钩子” 可能会将第一个缓冲区视为被丢弃,并清理其中的一个元素,而这个元素在第二个缓冲区中仍然有效。
为了便于清理,所有这些钩子必须是幂等的。在某些情况下,它们可能会被多次应用于同一对象。与执行类级别 instanceOf 检测的 doOnDiscard 操作符不同,全局的钩子处理的实例可以是任何 Object。区分哪些实例需要清理和不需要清理,取决于用户的实现。
|
9.9.1. doOnDiscard 操作符 或者本地钩子
该钩子专门用于清理那些永远不会被用户代码暴露的对象。它旨在用于在正常情况下运行的流(而不是推送很多元素且被 onNextDropped 覆盖的错误的源)的清理钩子。
它是局部的,即它是通过操作符激活的,并且仅应用于给定的 Flux 或者 Mono。
很明显的情况包括从上游过滤元素的操作符。这些元素永远不会到达下一个操作符(或最终订阅者),但这是正常执行途经的一部分。因此,它们被传递到 doOnDiscard 钩子。你可能使用 doOnDiscard 钩子的例子包括以下情况:
-
filter: 不符合过滤器的项被视为 “丢弃”。 -
skip:跳过的项将被丢弃。 -
buffer(maxSize, skip)与maxSize < skip:“丢弃的缓冲区” — 缓冲区之间的元素被丢弃。
但 doOnDiscard 并不局限于过滤操作符,而且还被用于在内部对数据进行排队以达到背压目的的操作符。更具体地说,在大多数情况下,这在取消过程中很重要。从源中预先提取数据,然后按需发布到订阅者的操作符可能在被取消时还未发出数据。这样的操作符使用 doOnDiscard 钩子在取消时清理它们内部的背压 队列。
doOnDiscard(Class, Consumer) 的每次调用都是与其它操作符一起的,以使其只能被其上游的操作符看到并使用。
|
9.9.2. onOperatorError 钩子
onOperatorError 钩子旨在以横向的方式修改错误(类似于AOP的捕获和重新抛出异常)。
当在处理 onNext 信号期间发生错误时,将要发出的元素被传递给 onOperatorError。
如果这种类型的元素需要清理,则需要在 onOperatorError 钩子中实现它,可能是在重写错误代码之上。
9.10. 空安全
尽管Java不允许在其类型系统中表示null安全,但Reactor现在提供了注解来声明API的可空性,类似与Spring5提供的注解。
Reactor使用这些注解,但是它们也可以用于任何基于Reactor的Java项目中来声明可空的API。方法体内使用的类型的可空性不在此功能范围之内。
这些注解是用 JSR 305 进行元注解(一种被IntelliJ IDEA之类的工具支持的潜在JSR),为Java开发人员提供与空安全相关的有用的警告,以避免运行时出现 NullPointerException。JSR 305 元注解允许IDE厂商以通用的方式提供空安全支持,而不必为Reactor注解提供硬编码支持。
| 在Kotlin 1.1.5+ 中,不需要也不建议在你的项目类路径下依赖 JSR 305。 |
reactor.util.annotation 包中提供了以下注解:
-
@NonNull:表示特定的参数,返回值或字段不能为null。(在使用@NonNullApi的参数和返回值上不需要它)。 -
@Nullable:表示参数,返回值或字段可以为null。 -
@NonNullApi:表示参数和返回值默认为非空的包级别注解。
| 尚不支持泛型类型参数,变量参数和数组元素的可空性。请看 issue #878 获取最新信息。 |
Suggest Edit to "高级特性和概念"
Appendix A: 我需要哪个操作符?
在本节中,如果一个操作符是针对 Flux 或 Mono,它会相应地加上前缀。普通的操作符是没有前缀的。当一个特定的用例被操作符组合覆盖时,它以方法调用的形式呈现,在括号中加上前导点和参数,如下所示:.methodCall(parameter)。
|
我想处理:
A.1. 创建一个新的序列…
-
发出
T,且我已经有了这个值:just-
…来自
Optional<T>:Mono#justOrEmpty(Optional<T>) -
…从可能为`空` T:
Mono#justOrEmpty(T)
-
-
发出一个由方法返回的
T:也是just-
…延迟获取:使用
Mono#fromSupplier或在defer中包装just
-
-
发出几个
T,可以明确地列举:Flux#just(T…) -
迭代:
-
数组:
Flux#fromArray -
集合或可迭代:
Flux#fromIterable -
整数范围:
Flux#range -
为每个订阅提供了一个
流:Flux#fromStream(Supplier<Stream>)
-
-
从各种单值源发出的,例如:
-
一个
Supplier<T>:Mono#fromSupplier -
任务:
Mono#fromCallable,Mono#fromRunnable -
一个
CompletableFuture<T>:Mono#fromFuture
-
-
完成:
empty -
立即出错:
error-
…延迟构建
Throwable:error(Supplier<Throwable>)
-
-
不做任何事情:
never -
在订阅时决定:
defer -
依赖于一次性资源:
using -
以编程的方式生成事件(可以使用状态):
-
同步逐个生成:
Flux#generate -
异步(也可以同步),可以一次发射多个信号:
Flux#create(Mono#create没有发射多个信号的特性)
-
A.2. 转换已有的序列
-
我想转换已有的数据:
-
按一对一(如字符串的长度):
map-
…通过映射:
cast -
…为了实现每个源值的索引:
Flux#index
-
-
在1对n的基础上(如字符串到其字符):
flatMap+ 使用一个工厂方法 -
在1对n的基础上,对每个源元素和/或状态提供编程行为:
handle -
为每个源条目(如,url到http请求)执行一个异步任务:
flatMap+ 一个异步的Publisher返回方法-
…忽略一些数据:在flatMap lambda中有条件地返回一个
Mono.empty() -
…保留原始序列的顺序:
Flux#flatMapSequential(这会立即触发异步处理,并重新排序结果) -
…异步任务可以从一个
Mono源返回多个值:Mono#flatMapMany
-
-
-
我想将预设元素添加到现有序列中:
-
在开始:
Flux#startWith(T…) -
在末尾:
Flux#concatWith(T…)
-
-
我想聚合一个
Flux:(假设前缀为Flux#)-
聚合到List:
collectList,collectSortedList -
聚合为Map:
collectMap,collectMultiMap -
聚合到任意容器中:
collect -
聚合为序列的大小:
count -
通过在每个元素之间应用函数(例如,计算总和):
reduce-
…但发出每个中间值:
scan
-
-
从谓词聚合为布尔值:
-
应用于所有值(和):
all -
应用于至少一个值(或):
any -
测试是否存在任何值:
hasElements -
测试是否存在特定值:
hasElement
-
-
-
我想组合生产者…
-
按顺序:
Flux#concat或.concatWith(other)-
…延迟任何错误,直到剩余的生产者全部发出后:
Flux#concatDelayError -
…马上订阅后续发布者:
Flux#mergeSequential
-
-
按发出的顺序(组合后的发出和它们来时一样):
Flux#merge/.mergeWith(other)-
…不同类型(转换合并):
Flux#zip/Flux#zipWith
-
-
按配对值组合:
-
将两个Mono组合成一个
Tuple2:Mono#zipWith -
全部完成后从n个Mono中合并:
Mono#zip
-
-
通过配合它们的终止而合并:
-
将1个Mono和任何源合并为
Mono<Void>:Mono#and -
全部完成时从n个源合并:
Mono#when -
合并为任意容器类型:
-
每次所有的都发出:
Flux#zip(直到最小基数) -
每次有新的值时:
Flux#combineLatest
-
-
-
只考虑先发出的序列:
Flux#first,Mono#first,mono.or(otherMono).or(thirdMono),flux.or(otherFlux).or(thirdFlux) -
由源序列中的元素触发:
switchMap(每个源元素都映射到生产者) -
由生产者序列中的下一个生产者开始时触发:
switchOnNext
-
-
我想重复一个已有序列:
repeat-
…每隔一段时间:
Flux.interval(duration).flatMap(tick → myExistingPublisher)
-
-
我有一个空序列,但…
-
我要一个值代替:
defaultIfEmpty -
我想要另一个序列:
switchIfEmpty
-
-
我有一个序列,但我对值不感兴趣:
ignoreElements-
…我要想把完成的内容表示为
Mono:then -
…我想等待另一个任务结束后再去完成:
thenEmpty -
…我想在结尾切换到另一个
Mono:Mono#then(mono) -
…我想在末尾发出一个值:
Mono#thenReturn(T) -
…我想在最后切换到
Flux:thenMany
-
-
我有一个想要延迟完成的Mono…
-
…直到该值的派生的另一个生产者完成为止:
Mono#delayUntil(Function)
-
-
我想将元素递归地展开成一个序列图,并发出组合…
-
…首先展开图的宽度:
expand(Function) -
…首先展开图的深度:
expandDeep(Function)
-
A.3. 探测序列
-
在不修改最终顺序的情况下,我希望:
-
得到通知/执行其它行为(有时称为“副作用”):
-
发出:
doOnNext -
完成:
Flux#doOnComplete,Mono#doOnSuccess(包括结果,如果有的话) -
错误终止:
doOnError -
取消:
doOnCancel -
序列的“开始”:
doFirst-
这与
Publisher#subscribe(Subscriber)绑定的
-
-
订阅后:
doOnSubscribe-
如
subscribe后的Subscription确认 -
这与
Subscriber#onSubscribe(Subscription)绑定的
-
-
请求:
doOnRequest -
完成或错误:
doOnTerminate(Mono包括结果,如果有的话)-
但在传播到下游之 后 :
doAfterTerminate
-
-
任何类型的信号,表示为
信号:Flux#doOnEach -
任何终止条件(完成,错误,取消):
doFinally
-
-
记录内部发生了什么:
log
-
-
我想知道所有的事件:
-
每个事件都表示为
Signal对象:-
在序列外的回调中:
doOnEach -
而不是原始的onNext发出:
materialize-
…然后返回到onNexts:
dematerialize
-
-
-
作为日志中的一行:
log
-
A.4. 过滤序列
-
我想过滤一个序列:
-
基于任意条件:
filter-
…异步计算:
filterWhen
-
-
限制发出对象的类型:
ofType -
完全忽略值:
ignoreElements -
忽略重复的:
-
在整个序列(逻辑集合)中:
Flux#distinct -
在后续发出的条目(重复数据删除)之间:
Flux#distinctUntilChanged
-
-
-
我只想只保留序列的一个子集:
-
取N个元素
-
在序列的开头:
Flux#take(long)-
…按时间周期:
Flux#take(Duration) -
…只有第一个元素作为一个
Mono:Flux#next() -
…使用
request(N)而不是取消:Flux#limitRequest(long)
-
-
在序列的末尾:
Flux#takeLast -
直到满足条件(包括)为止:
Flux#takeUntil(基于谓词),Flux#takeUntilOther(基于生产者的另外的生产者) -
满足条件(不包括)时:
Flux#takeWhile
-
-
最多取一个元素:
-
在某个位置:
Flux#elementAt -
在末尾:
.takeLast(1)-
…如果为空则发出错误:
Flux#last() -
…如果为空,则发出默认值:
Flux#last(T)
-
-
-
通过跳过元素:
-
在序列的开头:
Flux#skip(long)-
按时间周期:
Flux#skip(Duration)
-
-
在序列的末尾:
Flux#skipLast -
直到满足条件(包括)为止:
Flux#skipUntil(基于谓词),Flux#skipUntilOther(基于生产者的另外的生产者) -
满足条件时(不包括):
Flux#skipWhile
-
-
通过采样元素:
-
按时间周期:
Flux#sample(Duration)-
将第一个元素保留在采样窗口中,而不是最后一个:
sampleFirst
-
-
by a publisher-based window:
Flux#sample(Publisher) -
基于生产者窗口:
Flux#sample(Publisher) -
基于生产者的 “超时”:
Flux#sampleTimeout(每个元素触发一个生产者,如果该生产者与下一个不重叠则发出)
-
-
-
我期望最多1个元素(如果多于一个,则会出错)…
-
如果序列为空,我想要一个错误:
Flux#single() -
如果序列为空,我想要一个默认值:
Flux#single(T) -
我也接收空序列:
Flux#singleOrEmpty
-
A.5. 处理错误
-
我想创建一个错误序列:
error…-
…替换成功完成的
Flux:.concat(Flux.error(e)) -
…替换成功 发出 的
Mono:.then(Mono.error(e)) -
…如果onNext之间的间隔太长:
timeout -
…延迟:
error(Supplier<Throwable>)
-
-
我想等效于try/catch:
-
抛出:
error -
捕获异常:
-
回退到默认值:
onErrorReturn -
回退到另一个
Flux或Mono:onErrorResume -
包装并重新抛出:
.onErrorMap(t → new RuntimeException(t))
-
-
finally块:
doFinally -
Java 7开始的使用方式:
using工厂方法
-
-
我想从错误中恢复…
-
通过回退:
-
回退到某个值:
onErrorReturn -
回退到
Publisher或Mono,取决于错误的不同:Flux#onErrorResume和Mono#onErrorResume
-
-
简单策略(最大尝试次数):
retry,retry(long)-
…由伴随的Flux触发:
retryWhen -
…使用标准的回退策略(带抖动的指数退避):
retryWhen(Retry.backoff(…))(另见Retry中的其他工厂方法)
-
-
-
我想处理背压 "错误"(从上游请求最大请求量,并在下游没有产生足够多请求时应用该策略)…
-
通过抛出一个特殊的
IllegalStateException:Flux#onBackpressureError -
通过丢掉多余的值:
Flux#onBackpressureDrop-
…除了最后一次看到的:
Flux#onBackpressureLatest
-
-
通过缓冲多余的值(有界或无界):
Flux#onBackpressureBuffer-
…当有界缓冲区也溢出时应用这种策略:使用
BufferOverflowStrategy的Flux#onBackpressureBuffer
-
-
A.6. 与时间的合作
-
我想将发出和测量的时间(
Tuple2<Long, T>)相关联…-
自订阅开始:
elapsed -
自始至今(计算机时间):
timestamp
-
-
如果在两次发出之间有太多的延迟,我希望序列被中断:
timeout -
我想得到以固定时间间隔的时钟周期:
Flux#interval -
我想在初始延迟后发出一个
0:静态的Mono.delay -
我想引入延迟:
-
在每个onNext信号之间:
Mono#delayElement,Flux#delayElements -
在订阅前发生:
delaySubscription
-
A.7. 拆分 Flux
-
我想按一个边界条件把
Flux<T>拆分成Flux<Flux<T>>:-
大小:
window(int)-
…重叠或下降的窗口:
window(int, int)
-
-
时间:
window(Duration)-
…重叠或下降的窗口:
window(Duration, Duration)
-
-
大小或时间(达到计数或者超时后窗口关闭):
windowTimeout(int, Duration) -
按元素上的谓词:
windowUntil-
…在下一个窗口中(
cutBefore形式)发出触发边界的元素:.windowUntil(predicate, true) -
…当元素匹配谓词时保持窗口打开:
windowWhile(不匹配的元素不被发出)
-
-
由控件生产者中的onNext表示的任意边界驱动:
window(Publisher),windowWhen
-
-
我想把
Flux<T>和边界内的缓冲元素拆分在一起…-
分成
List:-
通过大小边界:
buffer(int)-
缓冲区重叠或下降:
buffer(int, int)
-
-
通过持续时间边界:
buffer(Duration)-
…缓冲区重叠或下降:
buffer(Duration, Duration)
-
-
通过大小或时间边界:
bufferTimeout(int, Duration) -
通过任意条件边界:
bufferUntil(Predicate)-
…将触发边界的元素放到下一个缓冲区中:
.bufferUntil(predicate, true) -
…在谓词匹配时进行缓冲,并删除触发边界的元素:
bufferWhile(Predicate)
-
-
由控件生产者中的onNext表示的任意边界驱动:
buffer(Publisher),bufferWhen
-
-
拆分成任意 “集合” 类型
C:使用类似buffer(int, Supplier<C>)的形式
-
-
我想分割一个
Flux<T>,以便有相同特征的元素可以在同一个子flux中:groupBy(Function<T,K>)TIP: 注意,这将返回一个Flux<GroupedFlux<K, T>>,每个内部的GroupedFlux共享相同的K键,并可通过key()访问。
A.8. 回到同步的世界
注意:如果从在标记为 "仅非阻塞"(默认 parallel() 和 single() ) 的 Scheduler 调用,则除了 Mono#toFuture 之外的所有这些方法都会抛出一个 UnsupportedOperatorException 异常。
-
我有一个
Flux<T>,我希望:-
阻塞到我得到一个一个元素为止:
Flux#blockFirst-
…超时阻塞:
Flux#blockFirst(Duration)
-
-
阻塞到我得到最后一个元素为止(如果为空,则返回null):
Flux#blockLast-
超时阻塞:
Flux#blockLast(Duration)
-
-
同步切换到
Iterable<T>:Flux#toIterable -
同步切换到Java 8
Stream<T>:Flux#toStream
-
-
我有一个
Mono<T>,我希望:-
阻塞到我获取到值为止:
Mono#block-
…超时阻塞:
Mono#block(Duration)
-
-
CompletableFuture<T>:Mono#toFuture
-
A.9. 广播 Flux 到多个 Subscribers
-
我想将多个
Subscriber连接到一个Flux上:-
并决定何时用
connect()触发源:publish()(返回一个ConnectableFlux) -
并立即触发源(后面的订阅者看到随后的数据):
share() -
当注册了足够的订阅者后永久连接源:
.publish().autoConnect(n) -
当订阅者高于/低于阀值时自动连接和取消源:
.publish().refCount(n)-
…但是给每个新的订阅者一个机会,让它们在取消之前有机会进来:
.publish().refCountGrace(n, Duration)
-
-
-
我想缓存来自
Publisher的数据并将其重新发出到以后的订阅者:-
最多
n个元素:cache(int) -
缓存在
Duration(生命周期) 内的看到的最新元素:cache(Duration)-
…但保留不超过
n个元素:cache(int, Duration)
-
-
但没有立即触发源:
Flux#replay(返回一个ConnectableFlux)
-
Suggest Edit to "我需要哪个操作符?"
Appendix B: 常见问题和最佳实践,“我如何…?”
本节涵盖以下内容:
B.1. 如何包装一个同步阻塞调用?
通常情况下,信息源是同步且阻塞的。为了在你的Reactor应用中处理这些源,使用以下方式:
Mono blockingWrapper = Mono.fromCallable(() -> { (1)
    return /* make a remote synchronous call */ (2)
});
blockingWrapper = blockingWrapper.subscribeOn(Schedulers.boundedElastic()); (3)| 1 | 通过使用 fromCallable 创建新的 Mono。 |
| 2 | 返回异步阻塞资源。 |
| 3 | 确保每个订阅都发生在来自 Schedulers.boundedElastic() 创建的一个专用的单线程worker上。 |
你应该使用 Mono,因为源只返回一个值。你应该使用 Schedulers.boundedElastic,因为它会创建一个专门的线程来等待阻塞资源而不影响其它的非阻塞处理,同时还确保对可创建线程数量的限制,并且在峰值期间阻塞的任务可以排队和延迟。
注意,subscribeOn 并不会订阅 Mono。它指定了当订阅调用发生时要使用什么样的 Scheduler。
B.2. 我在我的 Flux 上使用了一个操作符,但似乎不适用。为什么会这样?
确保你的 .subscribe() 的变量已经受到你认为应该应用该变量的操作符的影响。
Reactor操作符就是修饰符。它们返回不同的实例来包装源序列并添加了行为。这就是为什么使用操作符的首选方式是 链接 调用。
比较以下两个例子:
Flux<String> flux = Flux.just("something", "chain");
flux.map(secret -> secret.replaceAll(".", "*")); (1)
flux.subscribe(next -> System.out.println("Received: " + next));| 1 | 错误就出在这里。结果没有附加到 flux 变量。 |
Flux<String> flux = Flux.just("something", "chain");
flux = flux.map(secret -> secret.replaceAll(".", "*"));
flux.subscribe(next -> System.out.println("Received: " + next));
下面的例子就更好了(因为比较简单):
Flux<String> secrets = Flux
  .just("something", "chain")
  .map(secret -> secret.replaceAll(".", "*"))
  .subscribe(next -> System.out.println("Received: " + next));
第一个版本输出如下:
Received: something
Received: chain
其它两个版本输出的预期值,如下所示:
Received: *********
Received: *****
B.3. 我的 Mono zipWith/zipWhen 从未被调用过
请看下面的例子:
myMethod.process("a") // this method returns Mono<Void>
        .zipWith(myMethod.process("b"), combinator) //this is never called
        .subscribe();
如果源 Mono 为 空 或 Mono<Void>(无论出于何种目的,Mono<Void> 都是空的),则某些组合永远不会被调用。
对于诸如 zip 静态方法或 zipWith、zipWhen 操作符之类的任何转换器来说都是典型的情况,它们(根据定义)需要从每个源中获取一个元素来生成其输出。
因此,在 zip 源上使用数据抑制操作符是有问题的。数据抑制操作符的例子包括 then(),thenEmpty(Publisher<Void>),ignoreElements() 和 ignoreElement(),以及 when(Publisher…)。
同样,使用 Function<T,?> 来调整它们行为的操作符,例如 flatMap,至少需要发出一个元素,以便于 Function 有机会应用。将这些应用于空(或 <Void>)序列,则永远不会产生一个元素。
你可以使用 .defaultIfEmpty(T) 和 .switchIfEmpty(Publisher<T>) 将空的 T 序列分别替换为默认值或回退的 Publisher<T>,这有助于避免某些情况。注意,这并不适用于 Flux<Void>/Mono<Void> 源,因为你只能切换到另一个 Publisher<Void>,它仍然保证是空的。下面的例子使用了 defaultIfEmpty:
zipWhen 之前使用 defaultIfEmptymyMethod.emptySequenceForKey("a") // this method returns empty Mono<String>
.defaultIfEmpty("") // this converts empty sequence to just the empty String
.zipWhen(aString -> myMethod.process("b")) //this is called with the empty String
.subscribe();B.4. 如何使用 retryWhen 来模拟 retry(3)?
retryWhen 操作符可能相当复杂。希望下面的代码片段可以通过尝试模拟一个简单的 retry(3) 来帮助你理解它是如何工作的:
AtomicInteger errorCount = new AtomicInteger();
Flux<String> flux =
		Flux.<String>error(new IllegalArgumentException())
				.doOnError(e -> errorCount.incrementAndGet())
				.retryWhen(Retry.from(companion -> (1)
						companion.map(rs -> { (2)
							if (rs.totalRetries() < 3) return rs.totalRetries(); (3)
							else throw Exceptions.propagate(rs.failure()); (4)
						})
));| 1 | 我们通过改编 Function lambda来自定义 Retry,而不是提供一个具体的类。 |
| 2 | 伴随的对象发出 RetrySignal,它记录了迄今为止的重试次数和最后一次失败的次数。 |
| 3 | 为了允许三次重试,我们考虑索引<3并返回一个值来发出(这里我们简单地返回索引)。 |
| 4 | 为了在错误中终止序列,我们在这三次重试之后抛出原始异常。 |
B.5. 我如何使用 retryWhen 进行指数退避?
指数退避会产生重新尝试,每次尝试之间的延迟会越来越长,这样就不会使源系统过载,也不会有全面崩溃的风险。理由是,如果源产生错误,它已经处于一个不稳定的状态,不太可能立即从错误中恢复过来。因此,盲目的立即重试可能会产生另一个错误,增加不稳定因素。
自从 3.3.4.RELEASE 之后,Reactor自带了一个用于重试的构建器,可与 Flux#retryWhen 一起使用:Retry.backoff。
下面的例子演示了一个简单的构建器的使用,在重试尝试延迟前后的钩子记录消息。它可以延迟重试并增加每次尝试之间的延迟(伪代码:延迟 = 尝试次数 * 100毫秒):
AtomicInteger errorCount = new AtomicInteger();
Flux<String> flux =
Flux.<String>error(new IllegalStateException("boom"))
		.doOnError(e -> { (1)
			errorCount.incrementAndGet();
			System.out.println(e + " at " + LocalTime.now());
		})
		.retryWhen(Retry
				.backoff(3, Duration.ofMillis(100)).jitter(0d) (2)
				.doAfterRetry(rs -> System.out.println("retried at " + LocalTime.now())) (3)
				.onRetryExhaustedThrow((spec, rs) -> rs.failure()) (4)
);| 1 | 我们将记录源发出的错误时间,并对其进行统计。 |
| 2 | 我们配置了一个指数退避重试,最多尝试3次,没有抖动。 |
| 3 | 我们还记录了重试发生的时间。 |
| 4 | 默认情况下,会抛出一个 Exceptions.retryExhausted 异常,最后一个 failure() 作为失败原因。这里我们将其自定义为直接以 onError 的形式发出原因。 |
订阅后,它将失败并在打印出以下内容后终止:
java.lang.IllegalArgumentException at 18:02:29.338
retried at 18:02:29.459 (1)
java.lang.IllegalArgumentException at 18:02:29.460
retried at 18:02:29.663 (2)
java.lang.IllegalArgumentException at 18:02:29.663
retried at 18:02:29.964 (3)
java.lang.IllegalArgumentException at 18:02:29.964
| 1 | 约100毫秒后第一次重试 |
| 2 | 约200毫秒后第二次重试 |
| 3 | 约300毫秒后第三次重试 |
B.6. 使用 publishOn() 时如何确保线程关联性?
如 调度器 中所描述的,publishOn() 可以用来切换执行上下文。publishOn() 操作符会影响到线程上下文,在它下面的链中的其它操作符都会在这个上下文中运行,直到出现一个新的 publishOn。因此,publishOn 的位置很重要。
请看下面的例子:
EmitterProcessor<Integer> processor = EmitterProcessor.create();
processor.publishOn(scheduler1)
         .map(i -> transform(i))
         .publishOn(scheduler2)
         .doOnNext(i -> processNext(i))
         .subscribe();
map() 中的 transform 函数在 scheduler1 的工作进程上运行,doOnNext() 中的 processNext 方法运行在 scheduler2 的工作进程上。每个订阅都有自己的工作进程,因此,推送到相应订阅者的所有元素都是在在同一个 Thread 上发布。
你可以使用单线程调度器来确保在链上不同阶段或不同订阅者的线程关联性。
B.7. 上下文日志记录的好的方式是什么?(MDC)
大多数日志框架都允许进行上下文日志记录,允许用户存储反映在日志模式中的变量,通常是通过叫做MDC(“映射诊断上下文”)的 Map 的方式来。这是Java中 ThreadLocal 最常见的用法之一,因此,此模式假设所记录的代码与 Thread 是一对一的关系。
在Java 8之前,这可能是一个安全的假设,但随着Java语言中函数式编程元素的出现,情况发生了一些变化…
让我们以一个命令式API的示例为例,该API使用了模版方法模式,然后切换为一个更具有函数式风格的。使用模版方法模式,继承发挥了作用。现在,在更为函数式的方法中,传递高阶函数来定义算法的“步骤”。现在的东西更多的是声明性的而不是命令式的,这使得库可以自由地决定每个步骤应该在哪里运行。例如,知道了哪些步骤的底层算法可以并行化,库就可以使用 ExecutorService 并行地执行某些步骤。
这种函数式API的一个具体例子是Java 8中引入的 Stream 及其 parallel() 风格。在并行 Stream 中使用MDC进行日志记录并不是免费的午餐:需要确保MDC在每个步骤中都能被捕获并重新应用。
函数式风格支持这样的优化,因为每个步骤都是线程不可知的和引用透明的,但是它可以打破MDC对单一 Thread 的假设。确保所有阶段都可以访问任何类型的上下文信息的最惯用的方法是通过组合链传递上下文。在Reactor开发过程中,我们遇到了同一类的问题,我们希望避免这种简单明了的方法。这就是引入 Context 的原因:只要使用 Flux 和 Mono 作为返回值,它就会通过执行链传播,让阶段(操作符)探测到其下游阶段的 Context。因此,Reactor中没有使用 ThreadLocal,而是提供了这个类似于map的对象,它绑定到一个 Subscription 而不是 Thread。
既然我们已经认定了MDC “只是在工作”,并不是在声明性API做出的最佳假设,那么我们如何在响应式流中的事件(onNext,onError 和 onComplete)执行与事件相关的上下文日志记录语句?
当想要以直接和明确的方式记录与这些信号的关系时,FAQ的这个条目提供了一个可能的中间解决方案。请确保事先阅读 为响应式序列添加上下文 章节,尤其是如何在操作符链的底部进行写操作,以使其让上方的操作符能看到。
要从 Context 获取上下文信息到MDC中,最简单的方式是使用一些样板代码将日志记录语句封装在一个 doOnEach 操作符中。该样板代码取决于你选择的日志框架/抽象和要放入MDC中的信息,因此它必须位于你的代码库中。
下面是这样一个围绕单个MDC变量的辅助函数的例子,并着重于使用Java9增强的 Optional API记录 onNext 事件:
public static <T> Consumer<Signal<T>> logOnNext(Consumer<T> logStatement) {
	return signal -> {
		if (!signal.isOnNext()) return; (1)
		Optional<String> toPutInMdc = signal.getContext().getOrEmpty("CONTEXT_KEY"); (2)

		toPutInMdc.ifPresentOrElse(tpim -> {
			try (MDC.MDCCloseable cMdc = MDC.putCloseable("MDC_KEY", tpim)) { (3)
				logStatement.accept(signal.get()); (4)
			}
		},
		() -> logStatement.accept(signal.get())); (5)
	};
}| 1 | doOnEach 信号包括 onComplete 和 onError。在这个例子中,我们只对记录 onNext 感兴趣 |
| 2 | 我们将从Reactor的 Context(看 Context API 章节) 提取一个有趣的值。 |
| 3 | 在这个例子中,我们使用SLF4J 2中的 MDCCloseable,允许使用try-with-resource语法在执行日志语句后自动清理MDC。 |
| 4 | 调用方以 Consumer<T>(onNext值的消费者)的形式提供正确的日志语句 |
| 5 | 如果在 Context 中没有设置预期的键,则使用另一种方式,MDC中不放置任何东西 |
使用这个样板代码可以确保我们是MDC的良好公民:我们在执行日志记录语句之前就设置了一个键,并在执行完之后立即将其删除。在后续的日志记录语句中,不会有污染MDC的风险。
当然,这只是一个建议。你可能对从 Context 获取多个值或在出现 onError 情况时记录一些事情更感兴趣。你可能想要为这些情况创建其它辅助方法,或者创建一个使用额外的lambda来覆盖更多领域的方法。
在任何情况下:前面的辅助方法的使用都可能类似于下面的响应式web控制器:
@GetMapping("/byPrice")
public Flux<Restaurant> byPrice(@RequestParam Double maxPrice, @RequestHeader(required = false, name = "X-UserId") String userId) {
	String apiId = userId == null ? "" : userId; (1)

	return restaurantService.byPrice(maxPrice))
			   .doOnEach(logOnNext(r -> LOG.debug("found restaurant {} for ${}", (2)
					r.getName(), r.getPricePerPerson())))
			   .subscriberContext(Context.of("CONTEXT_KEY", apiId)); (3)
}| 1 | 我们需要从请求头中获取上下文信息,将其放入到 Context 中 |
| 2 | 在这里,我们使用 doOnEach 将我们的辅助方法应用到 Flux 中。记住:操作符可以看到在它们下面定义的 Context 值。 |
| 3 | 我们使用选择的键 CONTEXT_KEY 将请求头中的值写入到 Context。 |
在这种配置中,restaurantService 可以在一个共享线程上发出数据,但日志仍能为每个请求引用正确的 X-UserId。
为了完整起见,我们还可以看到错误日志记录的辅助方法看起来像:
public static Consumer<Signal<?>> logOnError(Consumer<Throwable> errorLogStatement) {
	return signal -> {
		if (!signal.isOnError()) return;
		Optional<String> toPutInMdc = signal.getContext().getOrEmpty("CONTEXT_KEY");

		toPutInMdc.ifPresentOrElse(tpim -> {
			try (MDC.MDCCloseable cMdc = MDC.putCloseable("MDC_KEY", tpim)) {
				errorLogStatement.accept(signal.getThrowable());
			}
		},
		() -> errorLogStatement.accept(signal.getThrowable()));
	};
}
除了我们检查 Signal 是否是一个 onError 以及我们向日志语句lambda提供这个错误(Throwable)之外,没有什么变化。
在控制器中应用这个辅助方法和我们之前做的非常相似:
@GetMapping("/byPrice")
public Flux<Restaurant> byPrice(@RequestParam Double maxPrice, @RequestHeader(required = false, name = "X-UserId") String userId) {
	String apiId = userId == null ? "" : userId;

	return restaurantService.byPrice(maxPrice))
			   .doOnEach(logOnNext(v -> LOG.info("found restaurant {}", v))
			   .doOnEach(logOnError(e -> LOG.error("error when searching restaurants", e)) (1)
			   .subscriberContext(Context.of("CONTEXT_KEY", apiId));
}| 1 | 如果 restaurantService 发出错误,它将在这里用MDC上下文记录下来 |
Appendix C: Reactor-Extra
对于 reactor-core 具有高级需求的用户,reactor-extra 模块包含了额外的操作符和工具集。
由于这是一个单独的组件,你需要显式地将其添加到构建中。下面的例子显示了在Gradle中如何操作:
dependencies {
     compile 'io.projectreactor:reactor-core'
     compile 'io.projectreactor.addons:reactor-extra' (1)
}| 1 | 除了core模块外,还需要添加extra模块。关于使用BOM时不需要指定版本的原因,其它详细信息以及在Maven中的用法,请看 入门Reactor。 |
C.1. TupleUtils 和函数式接口
reactor.function 包含了补充Java 8 Function,Predicate 和 Consumer 的函数式接口,适用于三到八个值。
TupleUtils 提供了静态方法。这些方法充当这些函数式接口的lambda与对应的 Tuple 上的类似接口之间的桥梁。
这让你可以轻松地处理任何 Tuple 的独立部分,如下例所示:
.map(tuple -> {
  String firstName = tuple.getT1();
  String lastName = tuple.getT2();
  String address = tuple.getT3();

  return new Customer(firstName, lastName, address);
});
你可以将前面的例子改写如下:
.map(TupleUtils.function(Customer::new)); (1)| 1 | (因为 Customer 构造器符合 Consumer3 函数式接口签名) |
C.3. 重复和重试工具
reactor.retry 包含了帮助编写 Flux#repeatWhen 和 Flux#retryWhen 函数的工具集。入口点分别是 Repeat 和 Retry 接口中的工厂方法。
你可以将这两个接口都用作为可变的构建器,并且它们可以正确的实现在对应的操作符中要使用的 Function 签名。
从3.2.0开始,这些工具集提供的最高级的重试策略之一也是 reactor-core 主要模块的一部分。Flux#retryBackoff 操作符可作为指数退避来使用。
从3.3.4开始,Retry 构建器直接在core中提供,并且有了更多的可能的定制,基于一个封装了错误之外的额外状态的 RetrySignal。